白膜能当条件吗?training-free 白膜控制实验
把 Blender 里重建的无纹理几何(白膜)沿相机轨迹渲染,交给五类视频模型,看它能不能像 World in World 那样控制生成,而且不需要训练
结论速览
- 可以,但要分模型看。原版 MiniMax-H3 自带的 ref2va 就能把白膜当条件:白膜视频作为「编辑源」、照片作为「编辑后的首帧」,几何和相机跟白膜,外观跟照片,墙面是照片里的深炭灰,没有照抄白膜的灰色。4 个随机种子的整体重合度 0.23–0.69(均值 0.48),其中 3 个种子第一次左转在 0.78 以上。
- H3 的条件是一整套配合,缺一项就失败。要用官方六段式提示词(
[video editing + keyframe completion]),镜头描述要带逐段时间戳并和白膜视频一致,参考视频要补到和生成一样的 243 帧。去掉时间戳整体只有 0.171,不补帧 0.164;只有文字镜头描述(fl2va)也只有 0.143。 - 反直觉:参考视频越像照片,H3 越不跟相机。同样的设置下,换成彩色渲染、照片投影上色、按物体上色的白膜,第一次左转都停在床上(0.03–0.04)。纯白膜和照片外观差得远,模型才把它当成结构和相机来源。换成黑底白线的线稿同样可用(0.49 / 0.67),换成带颜色的法向图又失败(0.17):参考视频要无彩色。
- K/V 证据注入会把白膜当外观照抄。LingBot(经 World in World)和 SolarWM-H3 都是把证据画面的注意力 K/V 拼进生成过程;白膜进去,空洞或整个画面就变成灰色石膏(SolarWM 灰像素占比 1.00,LingBot 空洞和白膜的 PSNR 23–31 dB)。只在第 1 步注入、半权重、把 V 的统计量对齐到首帧,都分不开几何和外观。
- 解法:白膜先自动上色,只拿来补空洞。每个物体取它在照片里的中位色,乘上白膜的明暗,不用任何手写材质;照片看得见的地方仍用 WiW 从源视频投影的画面,看不见的空洞用上色白膜。这样几何跟白膜、墙是真实颜色、机器人保留并照常运动,3 个种子、平移相机都成立。
- 训练过的控制分支(我们不用训练)几何最强。H3 Fun-ControlNet 用白膜线稿控制,重合度 0.835–0.839(两个种子),平移相机 0.850;再把照片接成首帧,重合度 0.872(平移 0.885)、首帧 PSNR 约 29.7 dB,几何和照片外观都有了;4 个种子 0.81–0.90(均值 0.86),只跑 25 步和 40 步效果一样,在 MI350X 上一条约 10 分钟。Wan2.1-VACE 用白膜深度控制,生成画面的深度和白膜的相关系数 0.95(白膜本身 0.966),但照片只能迁移配色。
- 白膜可以直接用来做视频编辑。在 Blender 里改材质、渲染首帧并贴回机器人,配原来的白膜视频,原版 H3 把浅色墙、绿色被子、木地板一路带到镜头转到的新区域。
- 同一份白膜可以换参考图:首帧换成 Blender 改材质的版本,或者图像模型换了风格的图(对齐一下取景即可),外观跟着首帧走(色彩度从约 9 升到 48–52),Fun-ControlNet 的重合度不变(0.80–0.88)。
- 再加 8 个场景,结论不变:厨房、书房、餐厅、和室、Loft、办公室、咖啡馆、儿童房上,Fun-ControlNet 照片首帧 + 线稿平均 0.75(3 个种子都在 0.75 左右),每个场景都优于原版 H3(0.58–0.64),首帧 PSNR 26 dB 对 18 dB;两种方法都没有照抄灰色。换成平移镜头轨迹后整体 0.69,平移后的视角下降较多(0.68 → 0.56)。
- 按相关论文的标准指标再算一遍:Fun-ControlNet 的镜头旋转误差约 1°(原版 H3 6–7°),回访时和自己的画面高度一致(LPIPS 0.09 对 0.20);但回到原视角时不如 H3 像原照片(14.0 对 17.6 dB),外观会慢慢漂移。
- 和外部 baseline 比(WorldPlay、Voyager,10 个场景实跑):回访一致性和照片保真大幅领先(回访 LPIPS 0.054 对 0.33 / 0.52,MEt3R 0.017 对 0.23 / 0.13),相机和 Voyager 同档(3 个 seed 0.92°,Voyager 0.87°,WorldPlay 18.8°);VBench 美学仍低于 WorldPlay(见第十三节)。
- 超出照片视野的白膜不要当条件:重投影 + 深度测试标出「洞」(左转时洞占 56–94%)。Fun-ControlNet 把洞内控制 token 清零,并用照片重投影走 inpaint 通道后,洞内不再照抄 Astra 编的布局(边缘 F 从 0.41–0.63 降到 0.05–0.10),观测区对照片的 PSNR 从 13–17 升到 22–28 dB。生成的新视角再交给 Astra 扩模:1 轮就把左墙改成拱形露台(洞内 SAM 对 SAM IoU 0.02 → 0.47),参考视角指标不变。
- Claude Opus 5.5 建模不如 Astra,而且会传到视频里:8 个新场景上,Claude 跑 6 轮的物体 IoU 均值 0.48,Astra 跑 3 轮是 0.66,费用约为三分之一;换成 Claude 的白膜后,Fun-ControlNet 视频的对齐从 0.75 掉到 0.49,原版 H3 从 0.58 掉到 0.50。
- GPT-6.1 Sol 同样 3 轮略差于 Astra,费用约四分之一;续到 6 轮能追平:8 个新场景物体 IoU 0.623 对 0.660($8.02 对 $31.80),6 轮 0.670($16.90)。10 个场景里有 4 个第 1 轮脚本把小数写成英文单词、整轮报错。进视频的白膜仍用 Astra,省钱时可用 Sol 跑 6 轮(见第十节)。
- 换到彩色客厅也成立,但 H3 的镜头跟随有随机性。H3 照片 + 白膜在第二个场景同样没有照抄灰色(色彩度 33–36),4 个种子的物体对齐 0.29–0.56;Fun-ControlNet 照片首帧 + 白膜线稿 0.623,接近 Astra 渲染自己的 0.704。
- 局限:LingBot、SolarWM、VACE 的结论只来自卧室;新场景只比较了原版 H3 和 Fun-ControlNet,且 8 张新参考图里 7 张是生成图;平移相机下 H3 第一次左转的跟随更不稳定;证据铺满全画面时(SolarWM)机器人会在第 68 帧后消失。
一、白膜怎么渲染
场景用 GPT-6 Astra 在 Blender 里按照片重建,相机标定为 60° 视场角(见深度与相机页),沿 H3 的「换朝向回访」轨迹渲染 237 帧:先左转 40° 停住,回正;再左转 55° 并下俯 12°,停住,回正。
- 白膜:所有表面换成同一种浅灰漫反射,场景灯光不变。灯光是按深色墙调的,白膜会过曝,所以先低分辨率试渲三帧,自动把曝光压到 −2.83 EV。
- 深度 / 法向:用只发光的材质直接写数值;深度存 16 位逆深度(近亮远暗),法向是相机坐标系。
- 照片投影上色:每帧用白膜深度把像素反投到参考相机,做深度遮挡测试,看得见的地方取照片颜色,看不见的保留白膜;两个机器人所在的像素不取色。平均 51% 的像素拿到照片颜色,转得最远时只剩 6%。
- 均色白膜(自动上色):渲染物体 ID,每个物体取它在照片里可见像素的中位色(墙、地板这类被拆成很多块的面按组取色),乘上白膜的明暗。不使用任何材质。
二、原版 MiniMax-H3:用自带的 ref2va
ref2va 的视频参考不是 ControlNet 那种逐帧对齐的控制,而是在时间轴上拼在目标前面的上下文:Qwen3-VL 以 2 fps 读它(语义),视频 VAE 把每一帧编码成固定的锚点(像素)。保留什么、改什么完全由提示词决定,官方格式是六段式,任务前缀、保留标记和每个标签的角色都有固定写法。
「重合度」:在生成画面里用 SAM 3 分割床、床头柜、窗、门、床头板,与 3D 场景按同一相机投影的物体比 IoU,取 17 个采样帧平均;「第一次左转」看第 44、56 帧,「第二次左转」看第 180、196 帧。首帧 PSNR 和原始照片比较;机器人比例是检测到机器人的采样帧占比。
| 组 | 参考图 | 参考视频 | 提示词 | 整体 | 第一次左转 | 第二次左转 | 首帧 PSNR | 有机器人 |
|---|---|---|---|---|---|---|---|---|
| C | fl2va:照片作首帧,镜头只用文字描述 | 0.143 | 0.05 | 0.00 | 35.1 | 100% | ||
| A | 照片 | 彩色渲染 | 第一批 | 0.174 | 0.03 | 0.59 | 18.9 | 77% |
| B | — | 彩色渲染 | 第一批 | 0.361 | 0.06 | 0.84 | 13.6 | 83% |
| WA | 照片 | 白膜 | 第一批 | 0.207 | 0.03 | 0.58 | 16.4 | 80% |
| WB | — | 白膜 | 第一批 | 0.188 | 0.13 | 0.11 | 10.5 | 87% |
| WC | 照片 | 深度 | 第一批 | 0.166 | 0.02 | 0.01 | 17.2 | 100% |
| WD | 照片 | 照片投影上色 | 第一批 | 0.208 | 0.03 | 0.65 | 20.5 | 83% |
| R3a | 照片 | 白膜 | 官方格式 | 0.461 | 0.83 | 0.38 | 18.0 | 80% |
| R3a 种子 7 | 照片 | 白膜 | 官方格式 | 0.522 | 0.80 | 0.38 | 18.8 | 77% |
| R3a 种子 123 | 照片 | 白膜 | 官方格式 | 0.694 | 0.78 | 0.66 | 18.7 | 80% |
| R3a 种子 2025 | 照片 | 白膜 | 官方格式 | 0.226 | 0.59 | 0.40 | 20.2 | 80% |
| R3f | 照片 | 白膜线稿 | 官方格式 | 0.491 | 0.80 | 0.39 | 18.6 | 77% |
| R3f 种子 123 | 照片 | 白膜线稿 | 官方格式 | 0.673 | 0.81 | 0.64 | 19.0 | 80% |
| R3n | 照片 | 法向(带颜色) | 官方格式 | 0.167 | 0.19 | 0.38 | 17.7 | 80% |
| R3b | — | 白膜 | 官方格式 | 0.501 | 0.71 | 0.39 | 11.8 | 83% |
| R3b 种子 7 | — | 白膜 | 官方格式 | 0.153 | 0.05 | 0.47 | 13.8 | 80% |
| R3b 种子 123 | — | 白膜 | 官方格式 | 0.430 | 0.92 | 0.14 | — | — |
| R3c | 照片 | 深度 | 官方格式 | 0.329 | 0.71 | 0.37 | 19.0 | 80% |
| R3a2 | 照片 | 彩色渲染 | 官方格式 | 0.190 | 0.03 | 0.67 | 20.4 | 80% |
| R3p | 照片 | 照片投影上色 | 官方格式 | 0.182 | 0.03 | 0.63 | 20.7 | 80% |
| R3m | 照片 | 均色白膜 | 官方格式 | 0.155 | 0.04 | 0.38 | 19.6 | 80% |
| R3d | fl2va:照片作首帧 + 彩色渲染第 208 帧作尾帧 | 0.211 | 0.32 | 0.44 | 31.0 | 81% | ||
| R3a 去掉时间戳 | 照片 | 白膜 | 镜头只写「跟随视频」 | 0.171 | 0.02 | 0.08 | 18.4 | 87% |
| R3a 不补帧 | 照片 | 白膜(237 帧,被截成 226) | 官方格式 | 0.164 | 0.22 | 0.33 | 17.3 | 80% |
- 第一批全部卡在第一次左转:旧格式下,带照片的组(A、WA、WC)整体只有 0.17–0.21,第 44–64 帧还停在床上。官方格式 + 用 1344×768 的照片 + 参考补帧之后,照片 + 白膜(R3a)第一次左转到 0.83;4 个种子里 3 个在 0.78 以上,种子 2025 只有 0.59,整体 0.23–0.69(均值 0.48)。
- 参考视频换成白膜线稿同样可用,换成法向图就失败:黑底白线的线稿(R3f)两个种子 0.491 / 0.673,和同种子的白膜(0.461 / 0.694)相当;带颜色的法向图(R3n)第一次左转只有 0.19。和彩色渲染、投影上色、均色白膜一样,参考视频一带颜色,镜头就跟不住;无彩色的结构参考(白膜明暗或线稿)才行。
- 只给白膜(R3b)不稳定:3 个种子 0.501 / 0.153 / 0.430,有的第一次左转失败,有的第二次左转失败。照片给了模型一个稳定的起点。
- 第二次左转(55°)大家都到了,但彩色、投影参考停得更准(0.59–0.84),白膜约 0.38:门的位置和大小有偏差。
- 深度视频(R3c)也能当结构参考,但比白膜弱,第一批格式下(WC)还多画了一扇门。
平移相机:有视差时还跟得住吗
同样的配方换成「平移回访」轨迹:第二段动作时相机一边左转 50°,一边向左平移 0.66 m、向前 0.22 m,靠近门口。白膜按米制轨迹重新渲染,提示词里的第二段镜头改成平移描述。
| 组 | 整体 | 第一次左转(同旋转轨迹) | 平移后的停留段 | 首帧 PSNR | 有机器人 |
|---|---|---|---|---|---|
| 照片 + 白膜 | 0.245 | 0.45 | 0.51 | 17.8 | 87% |
| 照片 + 均色白膜 | 0.230 | 0.22 | 0.60 | 19.4 | 87% |
| 只给白膜 | 0.415 | 0.48 | 0.55 | 12.0 | 80% |
平移后的视角跟到了(0.51–0.60),但这一次第一次左转只跟了一半(旋转轨迹上是 0.78–0.83),说明 H3 跟随视频参考的相机本身有随机性。
用白膜做视频编辑
首帧换成之前在 Blender 里改过材质的版本(浅暖灰墙、绿色条纹被子、蜂蜜色木地板,机器人从原图贴回),参考视频仍是原来的白膜,提示词把材质描述换掉。结果首帧和编辑图一致(SSIM 0.83),第一次左转 0.80,转到的新区域也是编辑后的风格。也就是说,只要改一张首帧,几何和镜头由白膜保证,H3 会把编辑传播到整段视频。
三、LingBot-World 2.0 + World in World:K/V 证据注入
World in World(WiW)的做法是:把证据画面(源视频按深度投影到目标相机的画面)在 t=0 过一遍冻结的 LingBot,取出每层注意力的 K/V,在前 3 个去噪步里拼进当前段的注意力,按可见度给 logit 加权。源视频看不到的区域是「空洞」,不给证据,由模型自己生成。我们沿用它的实现,只替换证据画面;相机内参改成标定的 60°(WiW 默认按 90° 处理这段视频)。
指标都在空洞区域里算(第 44 帧和第 196 帧镜头转开后露出来的墙、门、地板),取 3 个随机种子的均值:和白膜比的 PSNR 越高越像照抄白膜;和彩色渲染比的 PSNR 越高说明跟着上色的网格走;边缘相关衡量空洞里的几何是否跟白膜一致。
| 空洞里放什么 | 与白膜 PSNR | 与彩色渲染 PSNR | 饱和度 | 与白膜边缘相关 | 观察 |
|---|---|---|---|---|---|
| 不放(WiW 原生) | 9.2 / 9.7 | 12.4 / 11.6 | 0.22 / 0.15 | 0.01 / −0.02 | 空洞里编出圆镜、书桌、绿植,每个种子编的都不一样 |
| 白膜 | 23.4 / 30.6 | 11.0 / 12.0 | 0.08 / 0.08 | 0.16 / 0.12 | 几何跟上了,墙和地板照抄成灰色,机器人边缘有白色描边 |
| 彩色网格(Astra 材质) | 10.8 / 11.5 | 24.2 / 30.6 | 0.27 / 0.23 | 0.20 / 0.22 | 几何跟随,深炭灰墙,机器人保留 |
| 均色白膜(自动上色) | 9.7 / 10.9 | 21.9 / 22.7 | 0.31 / 0.26 | 0.28 / 0.23 | 和彩色网格几乎一样,闪烁最低;不需要任何材质 |
只跑了种子 42 的其他做法:白膜权重降到 0.25 时几何控制丢了,在白膜没有门的地方多编了一扇门;V 统计量对齐首帧后颜色偏紫蓝灰、地板长出砖纹;只在第 1 步注入时墙上多出开关面板和竖缝;整段画面都用白膜、彩色渲染或均色白膜当证据(不用源视频投影),会几乎逐帧照抄渲染,机器人消失。
平移相机
相机向左平移时,第 180–196 帧约 99% 的画面都是源视频没见过的空洞。先用 WiW 的深度和白膜的米制深度算出单位换算(0.136 m / WiW 单位,近处和远处并不完全一致),再统一相机运动。3 个种子平均:空洞补均色白膜时,空洞和均色白膜的 PSNR 31.8 / 34.1 dB、与白膜边缘相关 0.52 / 0.55、停留段闪烁 0.20;原生只有 10.3 / 9.9 dB、相关约 0,闪烁 0.65。
四、SolarWM-H3:我们的证据注入
SolarWM-H3 用和 WiW 同类的接口:证据画面在干净时刻过一遍冻结模型,取资产覆盖到的 token 的 K/V,从第 4 段(第 68 帧)起拼进注意力。种子 42,换朝向回访轨迹。
| 证据 | 整体重合度 | 第二次左转 | 色彩度 | 灰像素占比 | 有机器人 |
|---|---|---|---|---|---|
| 无(基线) | 0.461 | 0.09 | 6.6 | 0.63 | 97% |
| 彩色网格 | 0.764 | 0.72 | 9.4 | 0.41 | 30% |
| 白膜(全程注入) | 0.663 | 0.48 | 2.1 | 1.00 | 30% |
| 白膜,只在第 1 步注入 | 0.457 | 0.06 | 3.4 | 0.98 | 63% |
| 白膜,只在前 2 步注入 | 0.413 | 0.21 | 2.2 | 0.99 | 30% |
| 白膜,V 统计对齐首帧 | 0.707 | 0.69 | 3.8 | 0.87 | 30% |
| 白膜,半权重混合 | 0.506 | 0.06 | 4.3 | 0.83 | 63% |
| 白膜,只给家具 | 0.478 | 0.04 | 5.9 | 0.78 | 37% |
| 彩色网格,只在第 1 步注入 | 0.561 | 0.42 | 6.9 | 0.40 | 70% |
| 照片投影(只用看得见的像素) | 0.604 | 0.06 | 7.6 | 0.60 | 67% |
| 照片投影 + 白膜 | 0.559 | 0.15 | 6.0 | 0.72 | 30% |
| 均色白膜(自动上色) | 0.624 | 0.69 | 7.6 | 0.41 | 30% |
- 规律和 LingBot 一致:白膜进去几何能跟(0.663),但画面全灰;只在第 1 步注入,几何控制没了,灰色还在(低频的颜色恰好在最早几步定型);上色的网格最好,均色白膜颜色正常、第二次左转 0.69。
- 这里的证据是静态场景、铺满全画面,机器人在第 68 帧后消失(只剩 30%)。证据较弱或带空洞的组能保住 63–70%。LingBot 那种「源视频投影 + 白膜补空洞」的组合避开了这个问题。
五、现成的控制模型(训练好的,我们不用训练)
H3 Fun-ControlNet-Union 2.0
阿里 PAI 为 H3 训练的控制分支(10 层注入,支持深度、Canny、MLSD 等)。控制视频由白膜生成:深度用逆深度可视化,线稿 = 法向图的折线 + 深度图的遮挡边。官方管线只支持 t2va(外观全靠文字);「照片首帧」是我们参照 ComfyUI 的做法,给首帧条件行补零控制行接上的。
| 控制 | 整体重合度 | 第一次左转 | 第二次左转 | 首帧 PSNR | 有机器人 |
|---|---|---|---|---|---|
| 白膜线稿 | 0.839 | 0.89 | 0.72 | 13.2 | 77% |
| 白膜深度 | 0.624 | 0.61 | 0.59 | 12.4 | 80% |
| 照片首帧 + 深度 | 0.669 | 0.87 | 0.21 | 28.8 | 83% |
| 深度,控制强度 0.6 | 0.290 | 0.03 | 0.24 | 7.3 | 83% |
| 照片首帧 + 白膜线稿 | 0.872 | 0.90 | 0.72 | 29.8 | 80% |
| 白膜线稿,种子 7 | 0.835 | 0.90 | 0.90 | 13.0 | 80% |
| 平移轨迹:白膜线稿 | 0.850 | 0.90 | 0.98 | 13.6 | 80% |
| 平移轨迹:照片首帧 + 白膜线稿 | 0.885 | 0.91 | 0.98 | 29.7 | 83% |
| 照片首帧 + 线稿,种子 7 | 0.811 | 0.75 | 0.71 | 29.6 | 3% |
| 照片首帧 + 线稿,种子 123 | 0.864 | 0.89 | 0.92 | 29.5 | 77% |
| 照片首帧 + 线稿,种子 2025 | 0.897 | 0.81 | 0.94 | 29.7 | 70% |
| 照片首帧 + 线稿,控制强度 0.8 | 0.847 | 0.89 | 0.69 | 29.9 | 77% |
| 照片首帧 + 线稿,只跑 25 步 | 0.870 | 0.90 | 0.71 | 29.5 | 77% |
稳健性:照片首帧 + 线稿换种子很稳,卧室 4 个种子 0.872 / 0.811 / 0.864 / 0.897(均值 0.861),第二个场景 3 个种子 0.623 / 0.627 / 0.640。原版 H3 的照片 + 白膜,4 个种子在 0.23–0.69 之间。只跑 25 步和 40 步几乎没有差别(0.870 对 0.872,首帧 PSNR 和机器人比例都一样),耗时降到约六成。控制强度降到 0.8 略低(0.847)。要注意的是种子 7 几乎把机器人全丢了,只有 3% 的帧检测得到:动态主体在白膜里没有几何,能不能保住和种子有关。
线稿比深度强:深度在大面墙上几乎没有结构,线稿把墙角、踢脚线、门框、地板缝都画了出来。平移轨迹上第二次转身后的停留段达到 0.98。照片首帧的接法是经验性的(控制分支训练时没见过首帧条件行),首帧加深度时第二次左转明显变差,首帧加线稿则没有这个问题。
Wan2.1-VACE
832×480、81 帧、50 步。「深度相关」是生成画面估出的视差和白膜深度的相关系数(白膜渲染本身 0.966,真实照片对白膜深度 0.906)。
| 设置 | 深度相关 | 首帧 PSNR / SSIM | 观察 |
|---|---|---|---|
| 深度 + 参考图 | 0.953 | 15.7 / 0.72 | 几何和镜头完全跟随;照片只迁移配色材质,细节由模型编 |
| 只有深度 | 0.958 | 12.7 / 0.57 | 外观完全由文字决定,和照片不符 |
| 深度 + 照片作首帧 | 0.939 | 33.7 / 0.97 | 首帧锁住、色调继承照片;照片里有、网格里没有的机器人在第 1–2 帧消失 |
| 白膜当灰度控制 | 0.957 | 10.0 / 0.46 | 亮度被锁死,输出就是上了色的白膜,不可用 |
六、怎么选
| 需求 | 推荐做法 | 注意 |
|---|---|---|
| 外观来自照片、几何和镜头来自白膜,离线生成 | 原版 H3 ref2va:照片作编辑后的首帧 + 纯白膜视频,官方六段式提示词,镜头逐段写时间,参考补到 243 帧 | 不要给彩色或投影参考;第一次转身偶尔跟不全,建议多种子挑选 |
| 交互式 / 长时序世界模型(LingBot、WiW) | 白膜按物体自动上色,只补源视频投影的空洞 | 不要把纯白膜当证据,也不要整段画面都用网格证据 |
| 几何控制最准,外观也要像照片 | H3 Fun-ControlNet:照片首帧 + 白膜线稿(卧室 0.87,8 个新场景平均 0.75),25 步即可;或 VACE 深度 + 照片首帧 | 需要第三方控制权重;白膜要建准(换成粗糙的白膜会掉 0.26);照片里有、网格里没有的动态主体在 VACE 里会消失 |
| 视频编辑(改材质、换风格) | Blender 里改材质,渲染首帧贴回动态主体,配原白膜跑 H3 ref2va | 首帧里的动态主体需要从原图贴回 |
七、第二个场景:彩色客厅
为了检验结论能不能推广,换一张颜色丰富得多的客厅照片(淡紫墙、奶白布艺沙发、红紫黄抱枕、人字纹地板、绿植、挂衣架)。没有视频可以自标定,视场角用 MoGe-2 估计(53.6°);Astra 建模 3 轮,物体 IoU 0.458 → 0.524 → 0.569,深度误差 2.3%,有一个物体悬空。沿同一条换朝向轨迹渲染白膜,照搬卧室上的 R3a 配方(官方格式、逐段时间、补帧)。
这个场景用另一种对齐指标:直接拿 Blender 的物体 ID 图当真值,按名字归成沙发、抱枕、地毯、边桌、挂衣架、书架、植物、海报、坐墩、窗帘十类,和生成画面里 SAM 3 的分割比 IoU。Astra 的彩色渲染自己也只有 0.704(SAM 3 在渲染图上本身就有漏检),可以当作上限。
| 组 | 物体对齐 | 开头 | 第一次左转 | 第二次左转 | 色彩度 | 灰像素占比 | 首帧 PSNR |
|---|---|---|---|---|---|---|---|
| 原版 H3 照片 + 白膜,种子 42 | 0.375 | 0.63 | 0.39 | 0.20 | 35.6 | 0.08 | 19.3 |
| 原版 H3 照片 + 白膜,种子 7 | 0.289 | 0.63 | 0.00 | 0.39 | 33.1 | 0.30 | 18.5 |
| 原版 H3 照片 + 白膜,种子 123 | 0.562 | 0.63 | 0.38 | 0.62 | — | — | — |
| 原版 H3 照片 + 白膜,种子 2025 | 0.364 | 0.61 | 0.20 | 0.30 | — | — | — |
| Fun-ControlNet 白膜线稿 | 0.597 | 0.68 | 0.37 | 0.66 | 33.4 | 0.25 | 11.1 |
| Fun-ControlNet 照片首帧 + 白膜线稿 | 0.623 | 0.67 | 0.49 | 0.67 | 36.7 | 0.10 | 29.0 |
| Fun-ControlNet 照片首帧 + 白膜深度 | 0.599 | 0.64 | 0.47 | 0.63 | 42.4 | 0.07 | 28.6 |
| 参照:Astra 彩色渲染 | 0.704 | 0.71 | 0.65 | 0.74 | 20.7 | 0.54 | — |
| 参照:白膜本身 | — | — | — | — | 3.1 | 1.00 | — |
- 同样没有照抄灰色:生成视频的色彩度 33–36,比 Astra 的渲染还鲜艳,照片里的颜色和材质都保留了下来,新露出来的左墙也是淡紫色、地板是人字纹。
- 物体编号通道去掉 8 位抖动后重新评了一遍,这一节的数值只变了 0.001–0.004(例如 0.623 → 0.625、上限 0.704 → 0.708),排序不变,表中保留原值。
- 原版 H3 的镜头跟随随种子波动:4 个种子的物体对齐 0.29–0.56(均值 0.40)。种子 7 的动作整体晚了一截,第 54 帧还没转过去,第 120 帧才转到左墙,按固定帧采样就算成了 0。这和卧室上「只给白膜」不稳定的现象一致。
- Fun-ControlNet 在这个场景同样最稳:照片首帧 + 白膜线稿 0.623,已接近 Astra 渲染自己的 0.704;首帧 PSNR 29.0 dB,色彩度 36.7,外观来自照片。换种子 7、123 分别是 0.627、0.640,几乎不变。
八、再加 8 个场景
再换 8 张参考图:儿童房是真实照片,其余 7 张(厨房、带猫的书房、地中海餐厅、和室、Loft 客厅、家庭办公室、咖啡馆)是图像模型生成的写实室内图。每个场景都走同一套流程:Astra 建模 3 轮,沿同一条摇镜头轨迹渲染白膜和线稿,再用两种配方生成。一种是原版 H3 的照片 + 白膜(种子 42、7),一种是 Fun-ControlNet 的照片首帧 + 线稿(种子 43、7、123,25 步)。物体对齐以 Blender 物体编号为真值,编号通道关掉抖动后重渲;「上限」是 Astra 彩色渲染自己的得分。
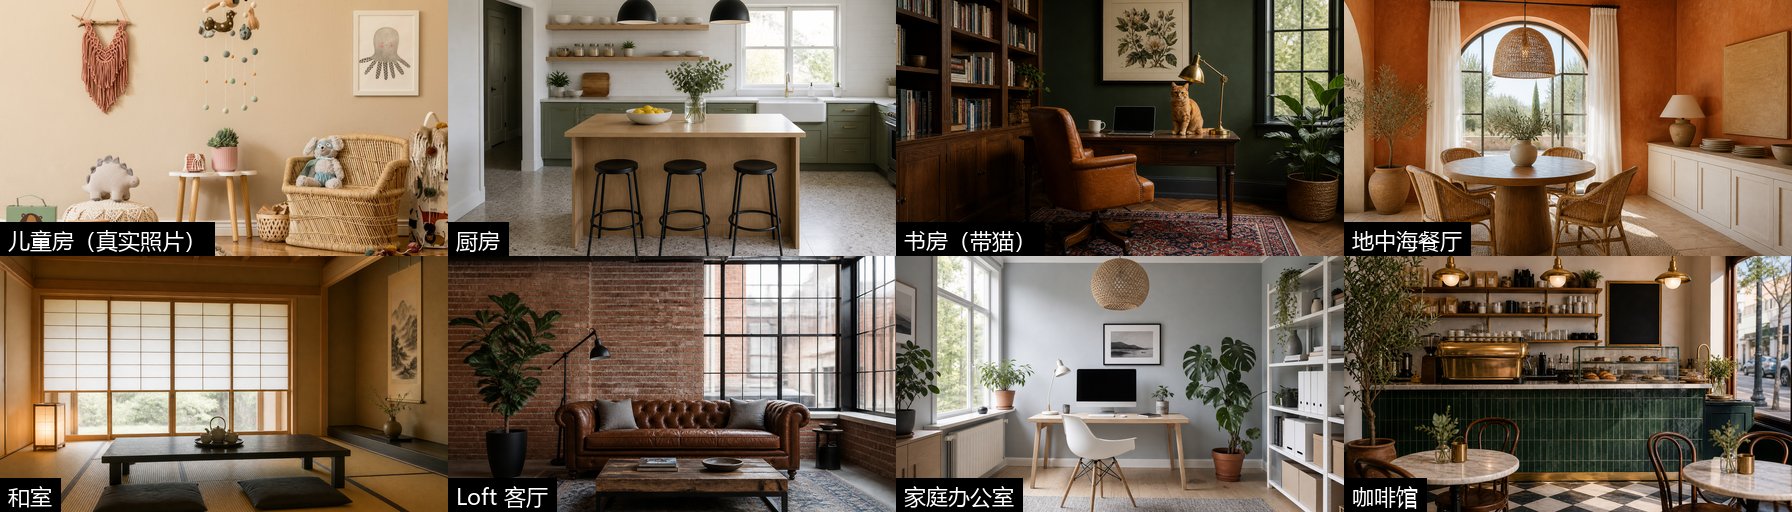
物体对齐:每个场景挑 6–10 类大件(家具、窗、柜、灯、地毯、植物;不含墙地顶),SAM 3 在生成画面里分割,与同一相机下 Blender 物体编号的并集比 IoU,取 12 个采样帧。两套白膜(Astra、Claude)用同一组类别,关键词逐个核对过命中的物体。
| 方法(8 个场景平均) | 物体对齐 | 起始段 | 第一次左转 | 第二次左转 | 首帧 PSNR / SSIM | 色彩度 | 灰像素 |
|---|---|---|---|---|---|---|---|
| 原版 H3 照片 + 白膜,种子 42 | 0.582 | 0.68 | 0.66 | 0.42 | 18.3 / 0.51 | 33.1 | 0.15 |
| 原版 H3 照片 + 白膜,种子 7 | 0.644 | 0.69 | 0.67 | 0.55 | 18.2 / 0.52 | 32.8 | 0.16 |
| Fun-ControlNet 照片首帧 + 线稿,种子 43 | 0.748 | 0.75 | 0.78 | 0.68 | 26.2 / 0.81 | 32.0 | 0.17 |
| Fun-ControlNet,种子 7 | 0.757 | 0.77 | 0.81 | 0.65 | 26.2 / 0.81 | 31.1 | 0.17 |
| Fun-ControlNet,种子 123 | 0.754 | 0.78 | 0.79 | 0.65 | 26.2 / 0.81 | 32.0 | 0.16 |
| 参照:Astra 彩色渲染 | 0.757 | 0.83 | 0.75 | 0.65 | 13.7 / 0.47 | 24.1 | 0.18 |
| 场景 | 原版 H3(种子 42 / 7) | Fun-ControlNet(种子 43 / 7 / 123) | 参照:Astra 渲染 | Astra 建模 IoU |
|---|---|---|---|---|
| 儿童房(真实照片) | 0.702 / 0.726 | 0.707 / 0.781 / 0.781 | 0.552* | 0.574 |
| 厨房 | 0.458 / 0.534 | 0.770 / 0.773 / 0.772 | 0.885 | 0.652 |
| 书房(带猫) | 0.536 / 0.638 | 0.606 / 0.609 / 0.669 | 0.685 | 0.656 |
| 地中海餐厅 | 0.548 / 0.554 | 0.827 / 0.801 / 0.809 | 0.774 | 0.706 |
| 和室 | 0.640 / 0.777 | 0.894 / 0.867 / 0.856 | 0.851 | 0.634 |
| Loft 客厅 | 0.549 / 0.697 | 0.777 / 0.738 / 0.736 | 0.840 | 0.793 |
| 家庭办公室 | 0.660 / 0.707 | 0.816 / 0.821 / 0.817 | 0.821 | 0.648 |
| 咖啡馆 | 0.559 / 0.516 | 0.590 / 0.668 / 0.589 | 0.651* | 0.619 |
- 8 个场景里,Fun-ControlNet 每一个都比原版 H3 好:平均 0.75 对 0.58–0.64,首帧 PSNR 26 dB 对 18 dB。Fun-ControlNet 三个种子的平均分只差 0.01,原版 H3 两个种子差 0.06。
- 两种方法都没有照抄灰色:生成视频的色彩度(31–33)和灰像素比例(0.15–0.17)与参考照片接近,比 Astra 的彩色渲染还鲜艳。
- Fun-ControlNet 已经和 Astra 彩色渲染的得分持平(0.757)。渲染分不是严格上限:SAM 3 对渲染图的识别本来就更差,儿童房的渲染严重过曝,咖啡馆的玻璃是透明的(*)。
- 最难的是书房和咖啡馆:两者第二次左转后的视角只有 0.35–0.58。这个视角看到的大多是参考图里没有、由 Astra 补出来的区域。
- 物体对齐不评墙面;单看 12 帧,分阶段数值有噪声。
每个视频四格:白膜线稿(控制)、原版 H3 照片 + 白膜、Fun-ControlNet 照片首帧 + 线稿、Astra 彩色渲染。
换成平移镜头轨迹
同样 8 个场景、同样的照片首帧 + 线稿(种子 43,25 步),镜头换成卧室用过的平移回访轨迹:第二段动作时边左转约 50°,边向左平移 0.66 m、向前 0.22 m。这条轨迹是按卧室设计的,换到这些房间后,平移结束时相机离左墙很近:儿童房和厨房只看得到整面墙(没有可评的物体),Loft 和咖啡馆只剩一两类物体。
| 场景 | 物体对齐:旋转 → 平移 | 平移后的停留段:旋转 → 平移 | 首帧 PSNR(平移) |
|---|---|---|---|
| 儿童房 | 0.707 → 0.717 | —(只有墙) | 28.2 |
| 厨房 | 0.770 → 0.742 | —(只有墙) | 27.8 |
| 书房 | 0.606 → 0.444 | 0.414 → 0.163 | 25.2 |
| 地中海餐厅 | 0.827 → 0.719 | 0.856 → 0.597 | 24.2 |
| 和室 | 0.894 → 0.890 | 0.909 → 0.886 | 28.0 |
| Loft 客厅 | 0.777 → 0.701 | 0.708 → 0.799(只剩盆栽) | 25.5 |
| 家庭办公室 | 0.816 → 0.833 | 0.840 → 0.858 | 26.6 |
| 咖啡馆 | 0.590 → 0.509 | 0.351 → 0.026(真值只有约 1% 面积) | 24.5 |
| 平均 | 0.748 → 0.694 | 0.680 → 0.555(6 个场景) | 26.3(旋转 26.2) |
- 平移之前两条轨迹是同一段镜头,结果也几乎一样(第一次左转 0.78 → 0.75);首帧不受影响。
- 平移之后对齐下降,但因场景而异:和室、办公室基本不变(0.89、0.86),餐厅和书房掉得多(0.60、0.16)。真正有区分度的只有这四个场景,要得到可靠的平移后指标,轨迹需要按房间调整方向。
九、同一白膜,换参考图
卧室的几何和镜头不变(同一份白膜和线稿),只换首帧照片:一张是之前在 Blender 里改材质的版本(浅暖灰墙、绿色条纹被子、蜂蜜色地板),一张是图像模型换的风格(陶土色墙、胡桃木地板、芥末黄被子;生成图的取景和原图不同,用 SIFT 特征匹配做相似变换对齐回原构图,中位误差 1.3 像素)。看外观能不能跟着参考图走,几何和镜头是否不受影响。
| 首帧照片 | 方法 | 整体重合度 | 第一次左转 | 第二次左转 | 首帧 PSNR / SSIM | 色彩度 | 有机器人 |
|---|---|---|---|---|---|---|---|
| 原照片 | Fun-ControlNet 首帧 + 线稿 | 0.872 | 0.90 | 0.72 | 29.8 / 0.93 | 约 9 | 80% |
| Blender 改材质 | Fun-ControlNet 首帧 + 线稿 | 0.802 | 0.68 | 0.95 | 31.9 / 0.96 | 49.2 | 80% |
| 图像模型换风格 | Fun-ControlNet 首帧 + 线稿 | 0.883 | 0.92 | 0.92 | 29.3 / 0.90 | 48.2 | 80% |
| 原照片 | 原版 H3 照片 + 白膜 | 0.461 | 0.83 | 0.38 | 18.0 / — | 约 9 | 80% |
| Blender 改材质 | 原版 H3 照片 + 白膜 | 0.298 | 0.80 | — | — / 0.83 | — | — |
| 图像模型换风格 | 原版 H3 照片 + 白膜 | 0.494 | 0.88 | 0.52 | 18.9 / 0.71 | 52.0 | 83% |
- 外观跟着照片走,几何和镜头跟着白膜走。原卧室是黑白灰配色,生成视频的色彩度约 9;换成陶土色或绿被子的首帧后升到 48–52,转到的新区域也是新风格。Fun-ControlNet 的重合度基本不受影响(0.80–0.88,原照片 0.87)。
- 换首帧不需要和白膜像素级一致:图像模型生成的换风格图只做了一次相似变换对齐,就和原照片一样好用。所以「换风格」可以直接用现成的图像编辑模型,不必回到 Blender 里改材质。
- 原版 H3 同样能换外观(陶土色版本 0.494,第一次左转 0.88),但首帧只是语义参考(PSNR 约 19 dB),Fun-ControlNet 则把首帧锁到 29–32 dB。
十、顺带:Claude Opus 5.5、GPT-6.1 Sol 和 GPT-6 Astra 谁建模更好
同样的 60° 标定输入、系统提示、反馈和评分,从零开始建 Blender 场景。
| 模型 | 物体 IoU(逐轮) | 深度误差 | 每轮耗时 | 费用 | 脚本长度 |
|---|---|---|---|---|---|
| GPT-6 Astra,4 轮 | 0.717 → 0.755 → 0.759 → 0.794 | 3.4–3.5% | 285–362 s | $3.82 | 688–1102 行 |
| Claude Opus 5.5,4 轮 | 报错 → 0.365 → 0.456 → 0.545 | 4.4–5.5% | 约 31 s | $0.50 | 123–139 行 |
| Claude 接着跑满 12 轮 | 最好 0.674 | 3.4–4.7% | 约 31 s | 约 $1.55 | 约 130 行 |
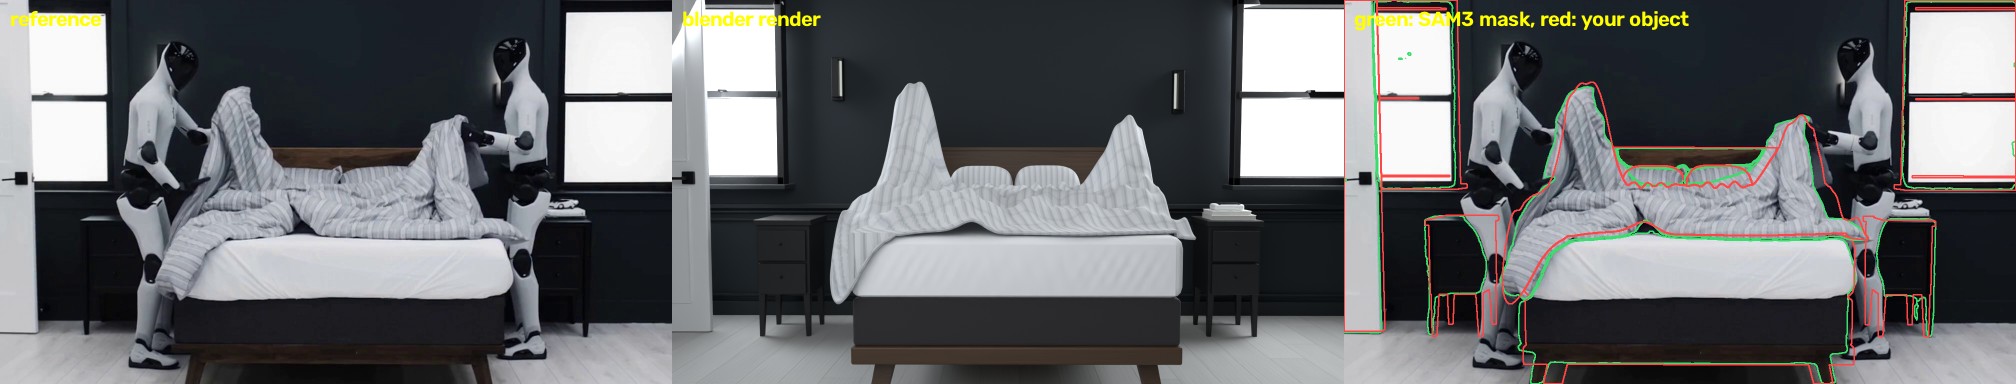
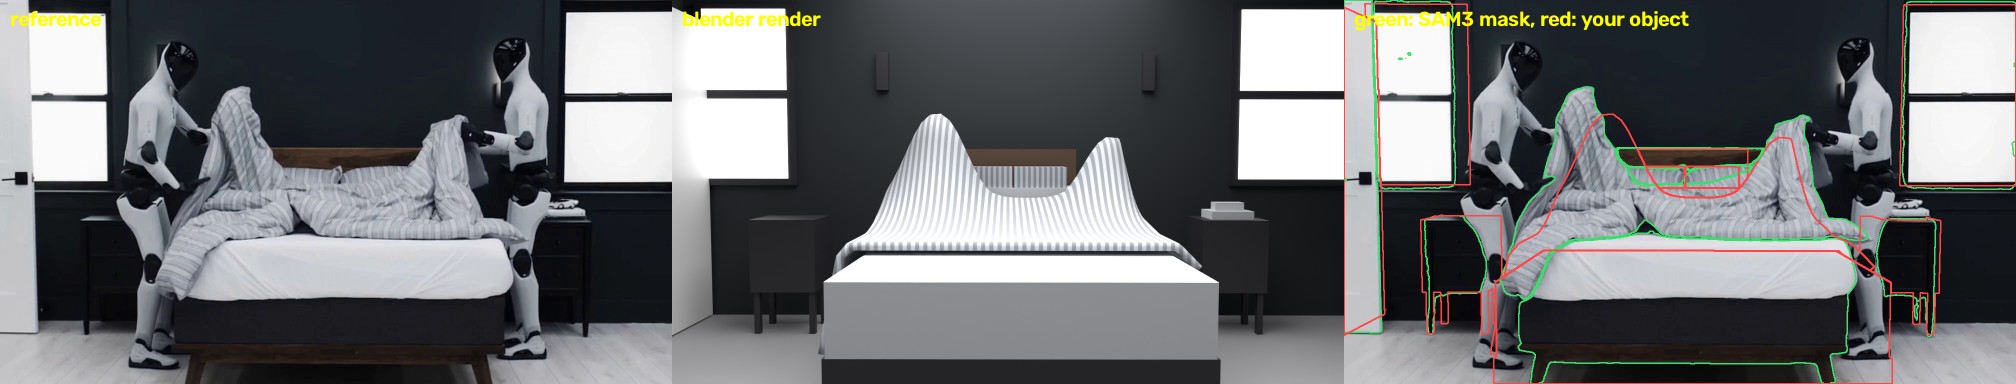
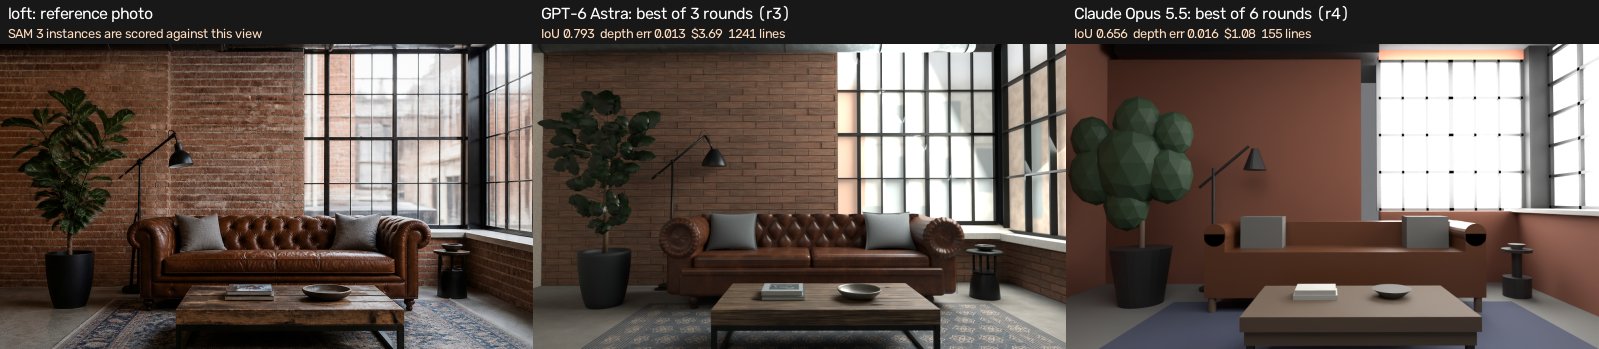
Astra 第 1 轮就超过了 Claude 12 轮的最好成绩;差距主要在细节量。Claude 快约 10 倍、便宜约 7 倍,适合快速迭代粗模。
再比 8 个场景:Astra 3 轮,Claude 6 轮
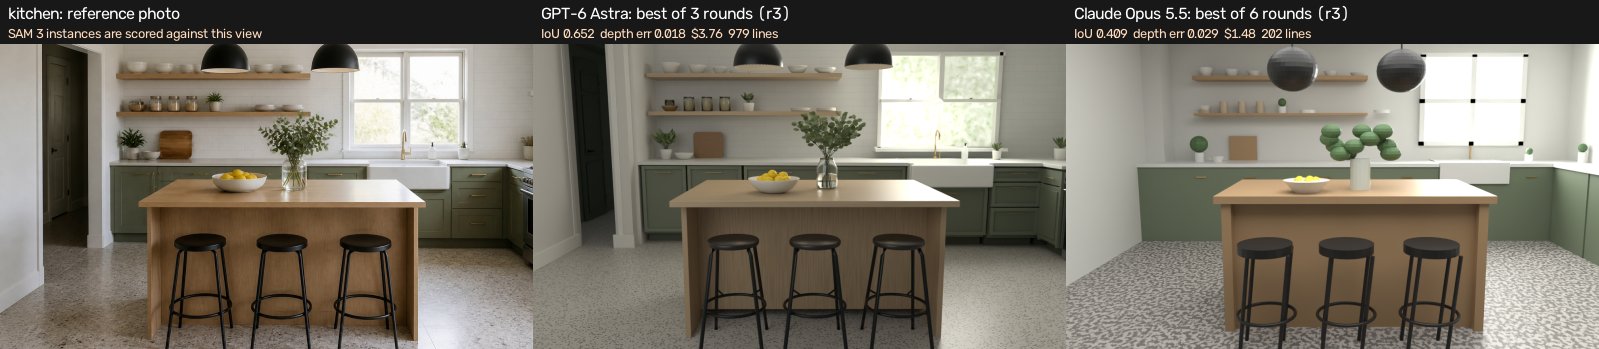
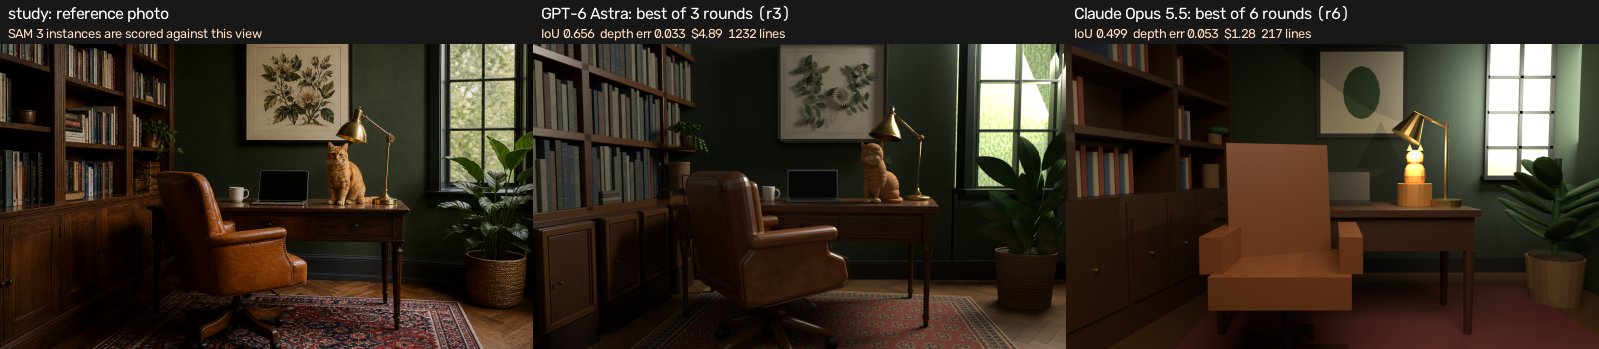
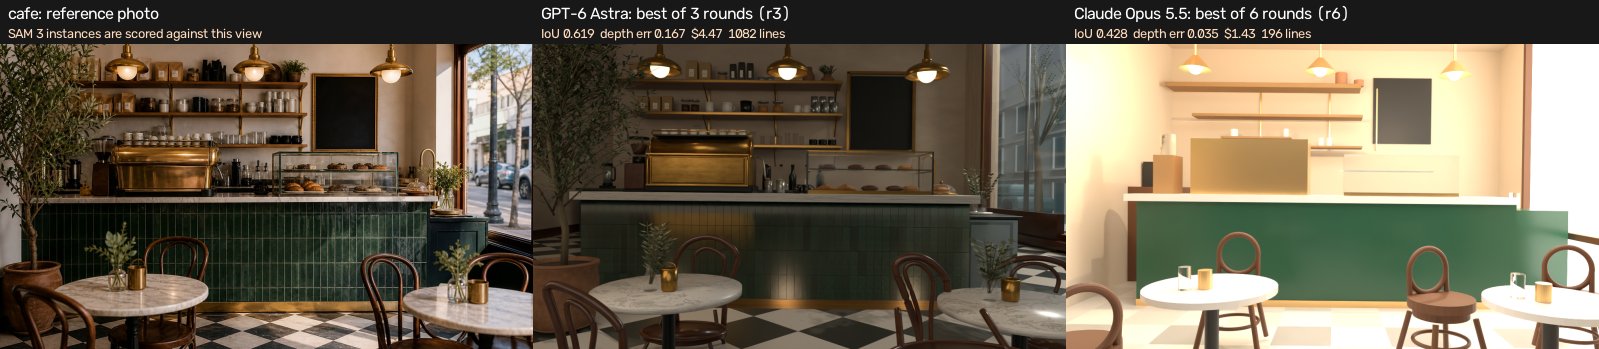
第八节的 8 个新场景,两个模型用同样的输入和反馈各建一遍。IoU 和深度误差取评分选出的那一轮(之后渲染白膜用的就是这一轮),费用和 LLM 时间是全部轮次的合计。
| 场景 | Astra IoU | Claude IoU | Astra 深度误差 | Claude 深度误差 | Astra 费用 | Claude 费用 | 脚本行数(A / C) |
|---|---|---|---|---|---|---|---|
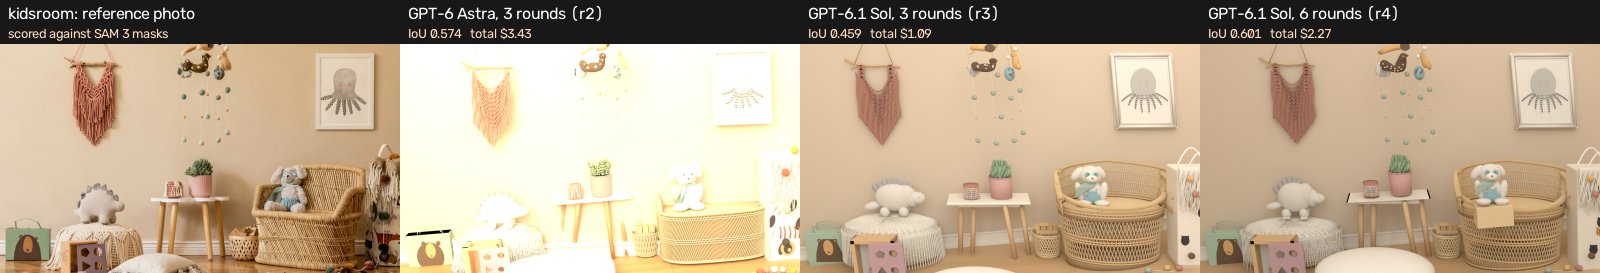
| 儿童房 | 0.574 | 0.388 | 32.8% | 2.7% | $3.43 | $1.13 | 1100 / 151 |
| 厨房 | 0.652 | 0.409 | 1.8% | 2.9% | $3.76 | $1.48 | 979 / 202 |
| 书房 | 0.656 | 0.499 | 3.3% | 5.3% | $4.89 | $1.28 | 1232 / 217 |
| 餐厅 | 0.706 | 0.483 | 4.4% | 6.3% | $2.80 | $1.01 | 1123 / 170 |
| 和室 | 0.634 | 0.476 | 1.2% | 4.9% | $3.80 | $0.90 | 1206 / 102 |
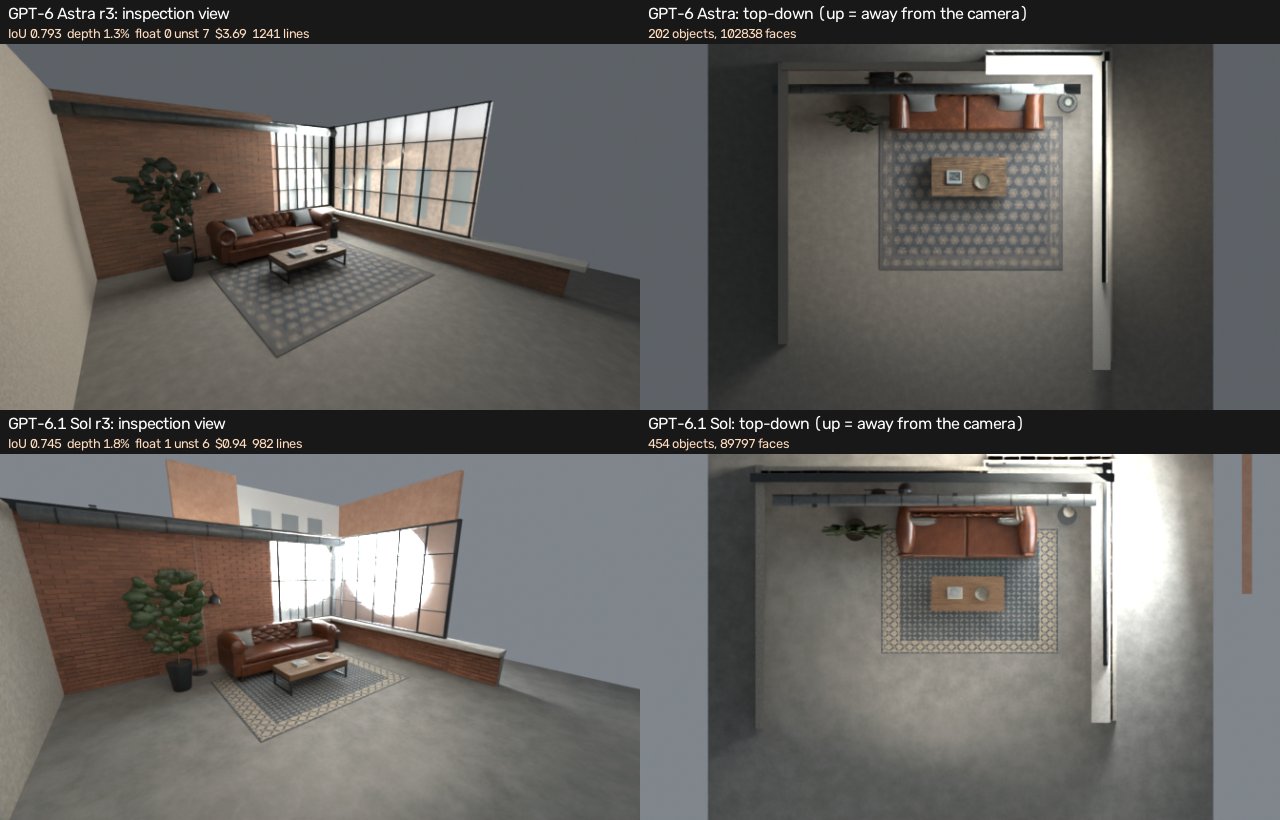
| Loft 客厅 | 0.793 | 0.656 | 1.3% | 1.6% | $3.69 | $1.08 | 1241 / 155 |
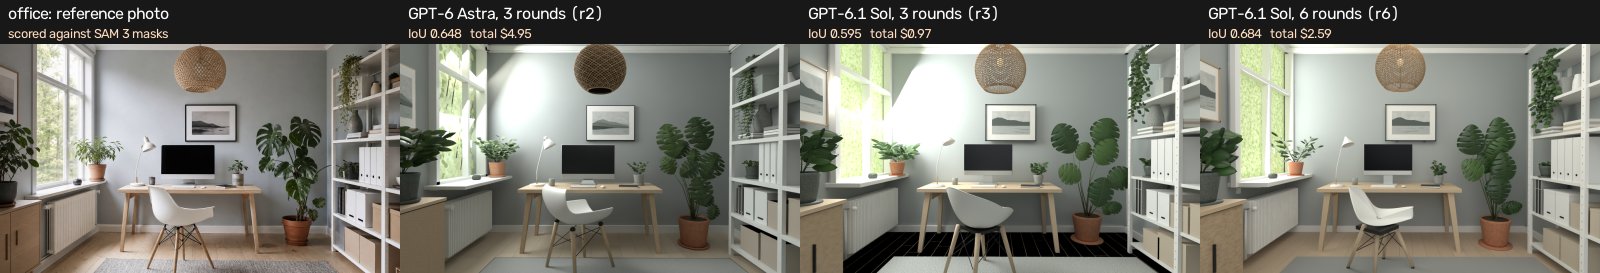
| 家庭办公室 | 0.648 | 0.533 | 1.6% | 3.5% | $4.95 | $1.31 | 1082 / 178 |
| 咖啡馆 | 0.619 | 0.428 | 16.7% | 3.5% | $4.47 | $1.43 | 1082 / 196 |
| 平均 / 合计 | 0.660 | 0.484 | 中位 2.6% | 中位 3.5% | $31.79 | $9.62 | 1131 / 171 |
Claude 每个场景都低于 Astra,轮数翻倍也没追上;第 1 轮均值 0.33 对 0.60,第 3 轮以后基本不再提高。费用约为 Astra 的三分之一,LLM 时间约四分之一(每次调用约 54 秒对约 6 分钟)。深度误差两者相当,Claude 还避开了 Astra 在儿童房和咖啡馆上的尺度错误;悬空和静置不稳两边都有。
白膜换成 Claude 建的,视频会差多少
8 个场景各用 Claude 的白膜再生成一遍(同样的照片和提示词),按 Astra 白膜的物体编号评分(更接近真实房间);括号里是按 Claude 自己白膜评分的结果(模型有没有跟着控制走)。
| 方法(8 个场景平均) | Astra 白膜 | Claude 白膜 | 变化 |
|---|---|---|---|
| Fun-ControlNet 照片首帧 + 线稿(种子 43) | 0.748 | 0.485(0.642) | −0.26,8 个场景全部下降 |
| 原版 H3 照片 + 白膜(种子 42) | 0.582 | 0.503(0.442) | −0.08,5 个场景下降 |
- 白膜越准,视频越好;Fun-ControlNet 对几何更敏感。它确实跟着 Claude 的几何走(按 Claude 白膜评分 0.642),所以 Claude 摆错的布局和粗糙的方块都原样进了视频:儿童房从 0.707 掉到 0.138,包、玩偶和藤椅都变成了木箱。
- 原版 H3 掉得少,是因为它本来就更跟照片、不那么跟白膜(按 Claude 白膜评分只有 0.442,还低于按 Astra 白膜)。
- 所以建模这一步值得花钱:Astra 贵约三倍,但用它的白膜生成的 Fun-ControlNet 视频,物体对齐高出约 0.26。
再比 GPT-6.1 Sol:同样 3 轮,再续到 6 轮
同样的输入、系统提示、反馈和评分,GPT-6.1 Sol 在 10 个场景上各从零建 3 轮:上面 8 个新场景,加上彩色客厅和机器人卧室(卧室的 Astra 取同一次从零运行的前 3 轮)。之后 8 个新场景接着跑第 4–6 轮。IoU 和深度误差取评分选出的那一轮,费用是全部轮次的合计。
| 场景 | Astra 3 轮 | Sol 3 轮 | Sol 6 轮 | 深度误差(A / S) | Astra 费用 | Sol 费用(3 / 6 轮) | 脚本行数(A / S) |
|---|---|---|---|---|---|---|---|
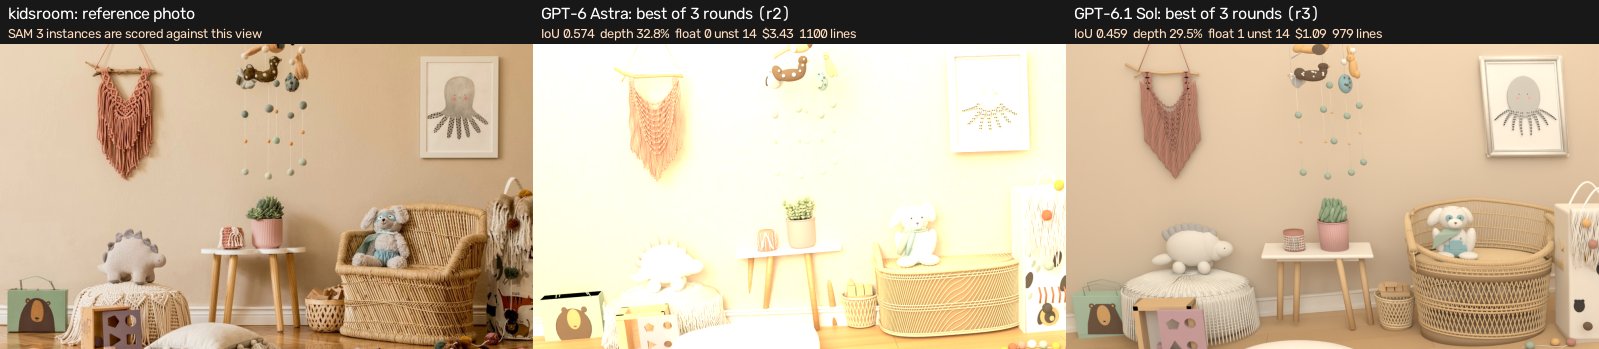
| 儿童房 | 0.574 | 0.459 | 0.601 | 32.8% / 29.5% | $3.43 | $1.09 / $2.27 | 1100 / 979 |
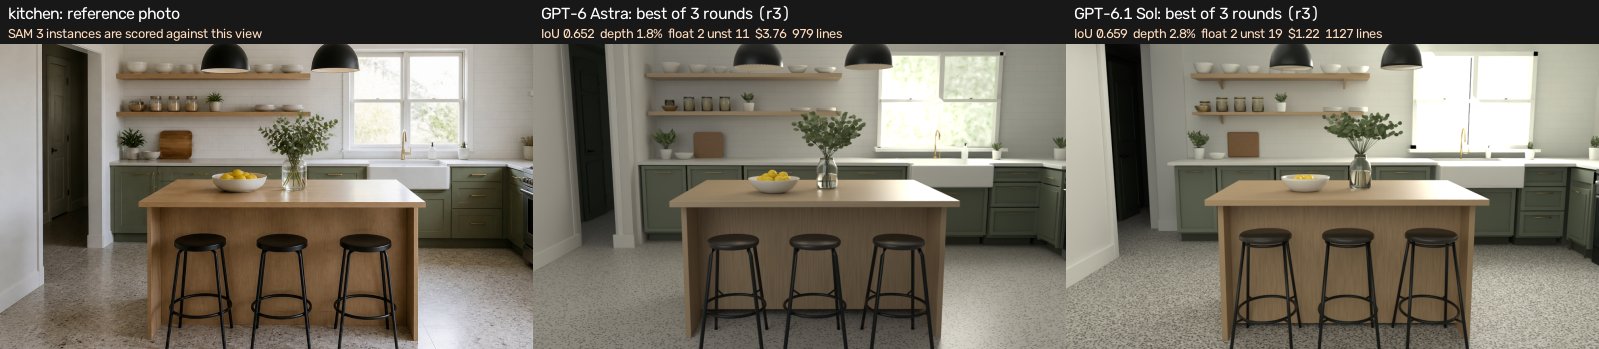
| 厨房 | 0.652 | 0.659 | 0.655 | 1.8% / 2.8% | $3.76 | $1.22 / $2.36 | 979 / 1127 |
| 书房 | 0.656 | 0.625 | 0.626 | 3.3% / 3.5% | $4.89 | $1.04 / $2.06 | 1232 / 1222 |
| 餐厅 | 0.706 | 0.667 | 0.686 | 4.4% / 3.2% | $2.80 | $0.98 / $1.90 | 1123 / 1014 |
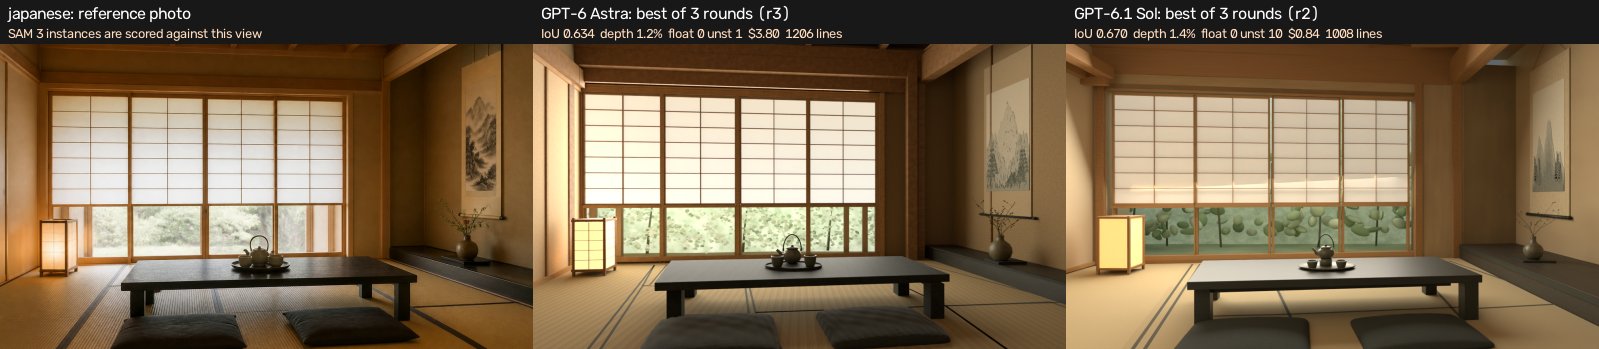
| 和室 | 0.634 | 0.670 | 0.684 | 1.2% / 1.4% | $3.80 | $0.84 / $1.61 | 1206 / 1008 |
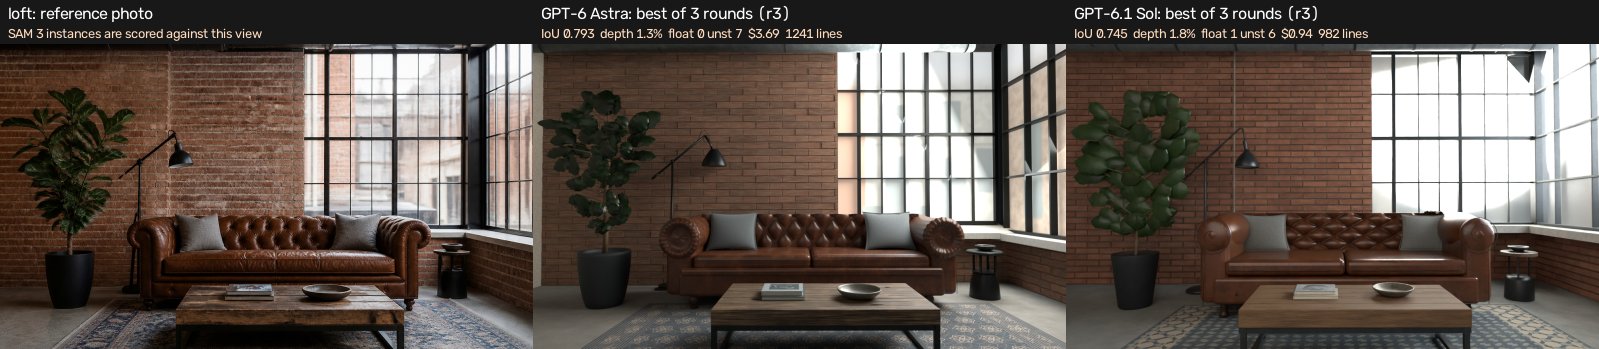
| Loft 客厅 | 0.793 | 0.745* | 0.791 | 1.3% / 1.8% | $3.69 | $0.94 / $2.12 | 1241 / 982 |
| 家庭办公室 | 0.648 | 0.595* | 0.684 | 1.6% / 1.6% | $4.95 | $0.97 / $2.59 | 1082 / 1151 |
| 咖啡馆 | 0.619 | 0.561* | 0.630 | 16.7% / 13.6% | $4.47 | $0.94 / $1.99 | 1082 / 1145 |
| 8 个新场景平均 / 合计 | 0.660 | 0.623 | 0.670 | 中位 2.6% / 3.0% | $31.80 | $8.02 / $16.90 | 1131 / 1078 |
| 彩色客厅 | 0.524 | 0.527 | — | 2.4% / 2.3% | $4.34 | $1.04 | 1351 / 1088 |
| 机器人卧室 | 0.759 | 0.742* | — | 3.5% / 3.3% | $2.50 | $0.61 | 776 / 711 |
| 10 个场景平均 / 合计 | 0.657 | 0.625 | — | 中位 2.9% / 3.0% | $38.64 | $9.67 | 1117 / 1043 |
* 第 1 轮脚本语法错误,这个场景实际只有 2 轮成功(见下)。
- 同样 3 轮,Sol 略低,费用约四分之一。10 个场景里赢 2 个(厨房、和室)、平 1 个、输 7 个;每轮费用中位 $0.31,Astra 约 $1.2。每次调用耗时中位 274 秒,Astra 是 370 秒,但 Sol 有 4 次超过 15 分钟,最长 34 分钟。
- 第 1 轮常常白费。10 个场景里有 4 个的第 1 轮脚本把小数写成了英文单词,比如
3. sixty if False else 3. sixty,整轮报错作废;之后各轮再没出现过,Astra 一次也没有。 - 多跑几轮,Sol 能追上。Astra 第 2 轮后基本不再提高;Sol 一直在涨,6 轮选中轮 0.670,略高于 Astra 3 轮的 0.660,花费约一半(每个场景 $2.1 对 $4.0)。8 个场景里赢 4 个、平 2 个、输 2 个(书房、餐厅)。
- 擅长和不擅长的物体不一样。柜子、搁架、天花梁、窗这类方正的建筑构件,Sol 不输甚至更准;细腿椅凳、吊灯、毛绒玩具和植物差一截(吧凳 −0.19,吊灯 −0.13,毛绒玩具 −0.27)。脚本长度和面数与 Astra 同一档,不像 Claude 那样只搭方块。
- 深度误差、覆盖率两者相当;儿童房和咖啡馆的尺度错误两个模型都有。静置不稳的物体,Sol 3 轮略多(81 对 62),6 轮后持平。
- 这次没有用 Sol 的白膜生成视频:3 轮的白膜不如 Astra,6 轮的与 Astra 持平;生成环境也不在本次可用的 GPU 节点上。
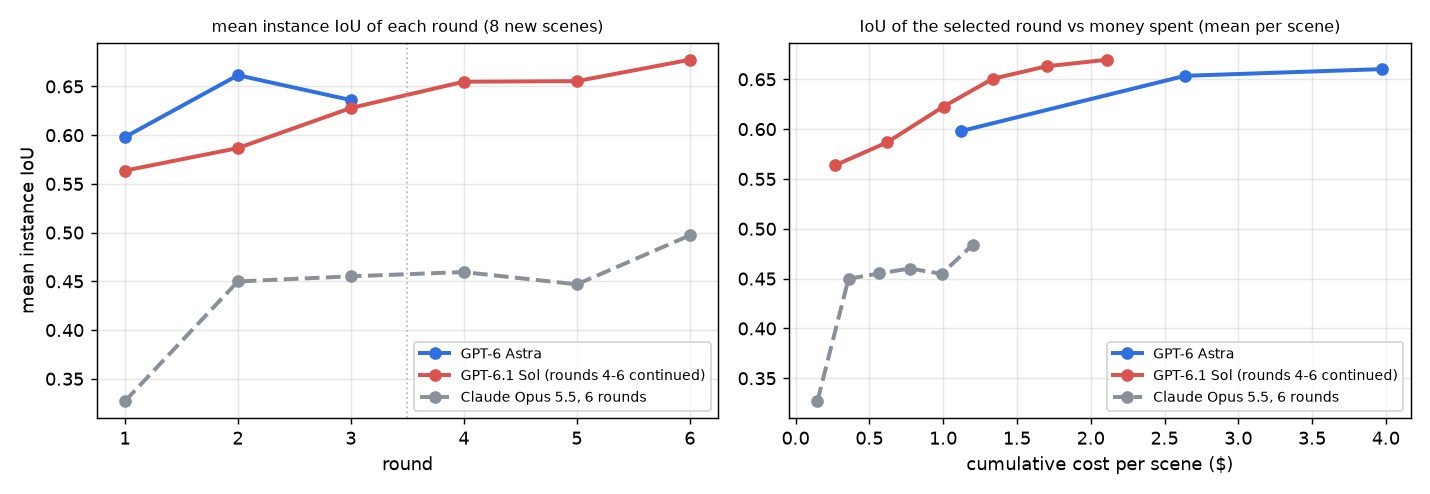
结论:要进视频的最终白膜仍用 Astra 3 轮(质量最高、不丢轮、耗时稳定);场景多、要省钱时用 Sol 6 轮,平均质量相同、费用约一半,但最好先加一道语法检查,免得第 1 轮白费。
十一、对照相关论文的标准指标
前面的物体对齐是我们自己的指标。这一节按相关论文的评估协议再算一遍,71 个生成视频全部参与,不需要真值视频:
- 相机精度:用 VGGT 估计生成视频的位姿,计算逐帧旋转误差(同 WorldScore 的 e_θ、ViewCrafter / WorldPlay 的旋转距离)。在白膜渲染上标定过,误差底噪约 0.4°。
- 回访一致性:回到照片视角时,与第一次访问的画面(自洽)和参考照片(该位姿的真值)比较 PSNR / SSIM / LPIPS(同 WorldPlay、VMem、Context-as-Memory)。
- 光度一致性:前后向光流往返误差(WorldScore;光流用 torchvision RAFT 代替 SEA-RAFT)。
- VBench:主体 / 背景一致性、运动平滑度、美学、成像质量,官方代码。
- 控制贴合:生成帧的单目深度对白膜深度的尺度不变误差(Cosmos-Transfer1 协议),以及边缘 F1(对白膜明暗图的 Canny,和对线稿本身)。
| 卧室(种子间平均) | 旋转误差 ↓ | 转到指令角的比例 | 回访 LPIPS ↓ | 回访对照片 PSNR ↑ | VBench 成像 ↑ | 深度误差 ↓ | 线稿 F1 ↑ |
|---|---|---|---|---|---|---|---|
| 原版 H3 照片 + 白膜(4 个种子) | 7.25° ± 2.98 | 0.83 | 0.286 | 15.85 | 67.9 | 0.124 | 0.235 |
| Fun-ControlNet 照片首帧 + 线稿(4 个种子) | 0.63° ± 0.07 | 0.98 | 0.071 | 15.40 | 70.9 | 0.086 | 0.542 |
| 参照:白膜渲染本身 | 0.77° | 1.08 | — | — | — | 0.046 | 0.306 |
| 8 个新场景平均 | 旋转误差 ↓ | 回访 LPIPS ↓ | 回访对照片 PSNR ↑ | 光流往返误差 ↓ | VBench 主体 / 美学 / 成像 | 深度误差 ↓ | 线稿 F1 ↑ |
|---|---|---|---|---|---|---|---|
| 原版 H3 照片 + 白膜 | 6.01° | 0.196 | 17.63 | 0.17 | 0.916 / 0.544 / 76.2 | 0.176 | 0.412 |
| Fun-ControlNet 照片首帧 + 线稿 | 1.24° | 0.090 | 14.04 | 0.47 | 0.887 / 0.522 / 76.5 | 0.129 | 0.656 |
- Fun-ControlNet 的镜头准得多:旋转误差约 1°,原版 H3 约 6–7°。H3 的误差主要来自转不够(卧室上只转到指令角的 83%),还把视场收窄了(估计约 51°,标定 60°)。
- Fun-ControlNet 自洽,但会慢慢偏离照片:回到照片视角时,它和自己第一次的画面几乎一样(LPIPS 0.07–0.09,H3 0.20–0.29),但和照片本身的 PSNR 反而低于 H3(8 个场景 14.0 对 17.6 dB)。它的第 0 帧几乎就是照片(26–34 dB),转开以后外观逐渐漂移,回来时保持漂移后的样子。这是下一步要补的短板。
- H3 的运动更平滑(光流往返误差 0.17 对 0.47),VBench 画质两者接近;控制贴合(深度、线稿)Fun-ControlNet 明显更好。
- 换成 Claude 白膜后,这些标准指标变化不大:Fun-ControlNet 旋转误差从 1.3° 升到 3.3°,对照片 PSNR 从 14.1 降到 12.7 dB,线稿 F1 从 0.63 降到 0.52;H3 基本不变。它们衡量的是镜头和画面一致性,看不出物体身份和布局的错误,第十节的物体对齐(0.75 → 0.49)才能看出来。
- 没算的:MEt3R 和 WorldScore 的 3D 一致性依赖 CUDA 扩展(pytorch3d、DROID-SLAM),ROCm 上需要移植;FVD / FID 没有参考视频集;旋转轨迹上平移误差没有定义。
十二、空洞机制:照片没看见的白膜不进条件
参考照片只覆盖自己的视野。镜头转出去以后看到的墙和家具,是 Astra 在照片外「编」出来的,不可靠;但原方案把整段白膜都当硬条件。这一节把没观测到的像素标成洞,洞里不喂控制,让视频模型自己生成,再用新视角反哺 Astra 扩模。
文献做法(training-free 能直接用的)
- GEN3C / ViewCrafter / Voyager / TrajectoryCrafter:把点云 / 3D 缓存沿目标相机渲染,渲染不到的就是洞,用二值 mask 标出来;模型学「已知区照抄、洞里补全」。这些都要训练。
- 我们的 Fun-ControlNet-Union-2.0 本身就是 inpaint 模型:
control_in_dim 49= 24 维控制 latent + 1 维可见性图 + 24 维被遮挡视频 latent。发布权重就是按 mask 训的;之前所有运行把后 25 维补零,等于训练时的「纯生成」状态。接口正好对上 GEN3C 式「缓存渲染 + mask」,不用再训。 - VACE 原生支持 MV2V outpaint:F = 照片重投影、M = 洞。WiW 的证据本来就按可见性加权,洞里没有证据。原版 H3 没有 mask 接口。
洞怎么定义
某帧某像素显示的白膜表面点,若投影到参考相机(第 0 帧)在画面内,且通过深度测试(|z_ref − z₀| < max(3 cm, 3%)),就算观测到;否则是洞。只旋转轨迹下,洞 ≈ 转出照片视野的部分。第二次左转时洞占画面的 79–94%。
三种处理,最好的是「清零 + inpaint」
| 变体 | 做法 | 洞内边缘 F ↓ | 观测区对照片 PSNR ↑ | 结论 |
|---|---|---|---|---|
| 全控制(原方案) | 整段线稿硬控 | 0.41–0.63 | 13–17 dB | 洞里照抄 Astra 编的布局 |
| 涂黑 | 洞内线稿置黑 | 0.05–0.34 | 13–18 dB | 模型把「没线」当平墙,仍部分照抄 |
| 零控制 | 洞内控制 token 清零 | 0.10–0.21 | 13–18 dB | 洞内基本不照抄;外观仍漂 |
| 零控制 + inpaint | 清零 + mask=洞 + 照片重投影 | 0.05–0.10 | 22–28 dB | 洞内自由生成,观测区被照片锁住 |
卧室 / 厨房 / 餐厅,seed 43,25 步,243 帧。餐厅地毯最直观:全控制洞内 IoU 0.93,零控制 0.38,inpaint 0.00(那里画了户外露台)。代价是两次访问同一片洞时内容不一定一致(复访 PSNR 从 27–32 降到 19–28 dB)——这正是闭环要解决的。
生成 → Astra 扩模闭环
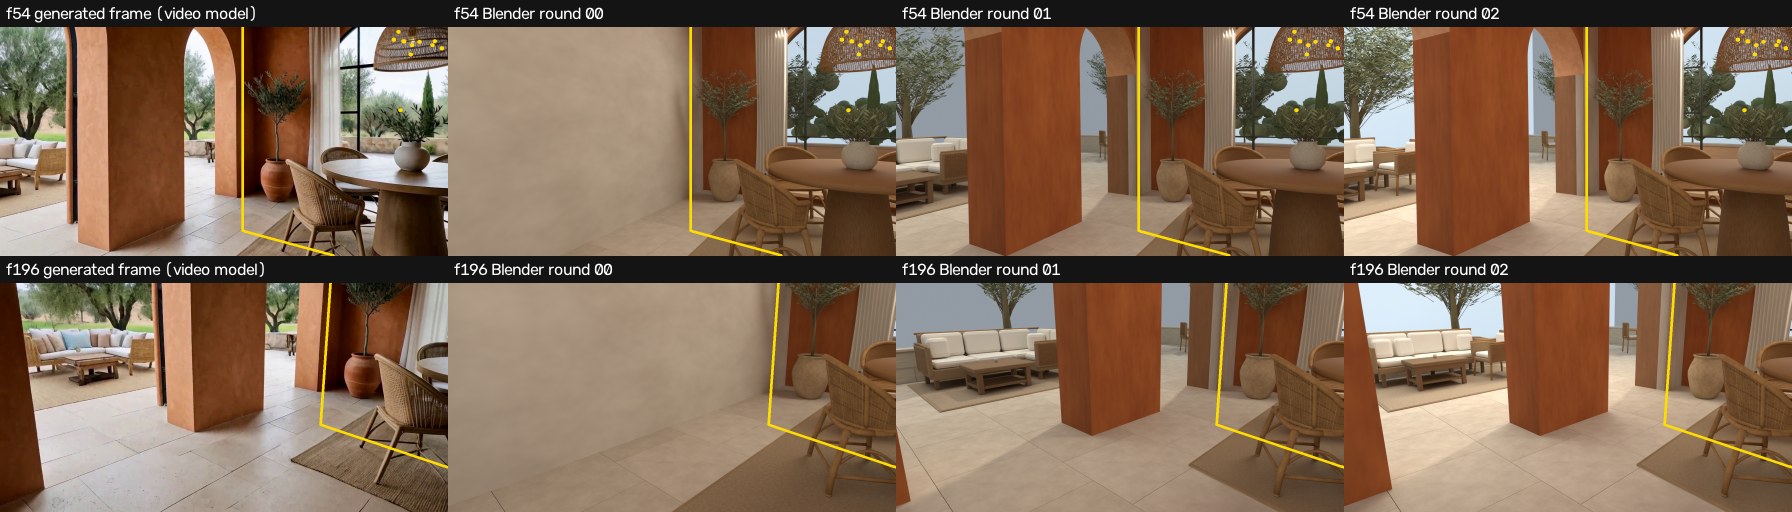
餐厅用「洞内零控制」视频,取洞最大的停留帧(第 54、196 帧)交给 Astra。第 1 轮($1.97)把照片外的左墙改成两个拱形露台开口,加户外藤编沙发、茶几、橄榄树;洞内 SAM 对 SAM IoU 从 0.02 → 0.47。第 2 轮($1.25)主要改名和细修(0.42)。参考视角实例 IoU 三轮都是 0.706,说明只改了照片外的部分。两轮共 $3.22。
- 推荐流程:洞 mask → Fun 照片首帧 + 洞内零控制线稿 + inpaint(照片重投影)→ 挑洞最大的停留帧给 Astra 扩模 → 用新模型重渲线稿做第二遍生成(原来的洞现在有几何约束,复访就一致)。
- 第二遍生成(餐厅):用扩展后网格的线稿全控制 + 照片 inpaint。同一片洞两次访问的 PSNR 从 19.1 升到 24.1 dB(不加 inpaint 是 26.2 dB),洞内和第一遍的一致性 15.1 dB(两次独立生成之间只有 10.5–11.6 dB),观测区对照片仍是 22.3 dB。
第二遍:用扩展后的模型重画
Astra 把第一遍视频在洞里「发明」的东西建进模型以后,原来的洞就有了几何。第二遍用新模型重渲的线稿做全控制,再加照片 inpaint(mask 仍是照片的洞),照片区域照抄、洞里跟着新网格画。餐厅这一轮用的是早期的「洞内零控制」视频(没加 inpaint)。
| 餐厅 | 洞内复访 PSNR | 洞内与第一遍一致 | 观测区对照片 PSNR | 洞内边缘 F(对新网格) |
|---|---|---|---|---|
| 全控制(旧网格) | 31.6 | 11.0 | 13.2 | 0.17 |
| 第一遍:洞内零控制(闭环的输入) | 19.1 | — | 13.2 | 0.39 |
| 第二遍:新线稿全控制 | 26.2 | 15.9 | 13.3 | 0.64 |
| 第二遍:新线稿 + 照片 inpaint | 24.1 | 15.1 | 22.3 | 0.60 |
PSNR 单位 dB。「洞内与第一遍一致」:照片的洞里、两段停留每 4 帧,与第一遍视频的 PSNR;两次互相独立的第一遍之间只有 10.5–11.6 dB,Astra 扩展后模型自己的渲染是 13.0 dB。旧网格在那里只是一面平墙,所以它的复访最容易一致。
自动化闭环:一条命令跑完整个流程
整条流程做成了一条可中断重跑的命令:洞 mask → 第一遍(洞内零控制 + 照片 inpaint)→ 每段停留里洞最大的一帧交给 Astra(这条轨迹选到第 54、198 帧)→ 每轮按不看名字的 SAM 对 SAM 洞内 IoU 打分,参考视角实例 IoU 掉超过 0.02、或出现新的悬空 / 静置测试里倒下的物体,这一轮就不能选 → 用选中的模型重渲线稿 → 第二遍(新线稿全控制 + 照片 inpaint;照片和关键帧都没见过、超过画面 5% 的残余洞里仍清零控制)→ 评测。先在卧室、厨房、书房、和室、Loft 五个场景上并行跑通(每个 46–66 分钟,10 轮 Astra、$13.30),之后扩到全部 10 个场景。
| 场景 | Astra 轮数 / 费用 | 选中 | 洞内 SAM 对 SAM IoU | 参考视角实例 IoU |
|---|---|---|---|---|
| 卧室 | 2 轮 / $3.28 | 第 1 轮 | 0.32 → 0.88 | 0.861 → 0.861 |
| 厨房 | 2 轮 / $2.05 | 第 2 轮 | 0.00 → 0.62 | 0.651 → 0.655 |
| 书房 | 2 轮(第 1 轮被门控拒绝)/ $2.95 | 第 2 轮 | 0.10 → 0.69 | 0.656 → 0.657 |
| 和室 | 2 轮 / $3.10 | 第 2 轮 | 0.01 → 0.14 | 0.633 → 0.647 |
| Loft | 2 轮 / $1.93 | 第 2 轮 | 0.47 → 0.70 | 0.794 → 0.794 |
| 场景 | 洞内复访 PSNR 第一遍 → 第二遍 | 洞内与第一遍一致 (独立生成参照) | 观测区对照片 PSNR 第一遍 / 第二遍 | 洞内边缘 F(对新网格) 第一遍 → 第二遍 |
|---|---|---|---|---|
| 卧室 | 21.0 → 28.2 | 19.1(11.9) | 28.5 / 28.5 | 0.19 → 0.48 |
| 厨房 | 27.9 → 28.5 | 19.1(17.0) | 26.9 / 26.8 | 0.06 → 0.46 |
| 书房 | 20.4 → 26.3 | 15.6(11.2) | 24.4 / 24.4 | 0.37 → 0.63 |
| 和室 | 22.8 → 30.8 | 20.7(17.3) | 24.6 / 24.5 | 0.52 → 0.64 |
| Loft | 18.3 → 19.4 | 16.5(16.0) | 24.0 / 23.9 | 0.70 → 0.84 |
PSNR 单位 dB,每个场景 1 个种子。「独立生成参照」= 旧网格全控制的视频(与第一遍互不相干)在同样的帧和区域与第一遍的 PSNR。
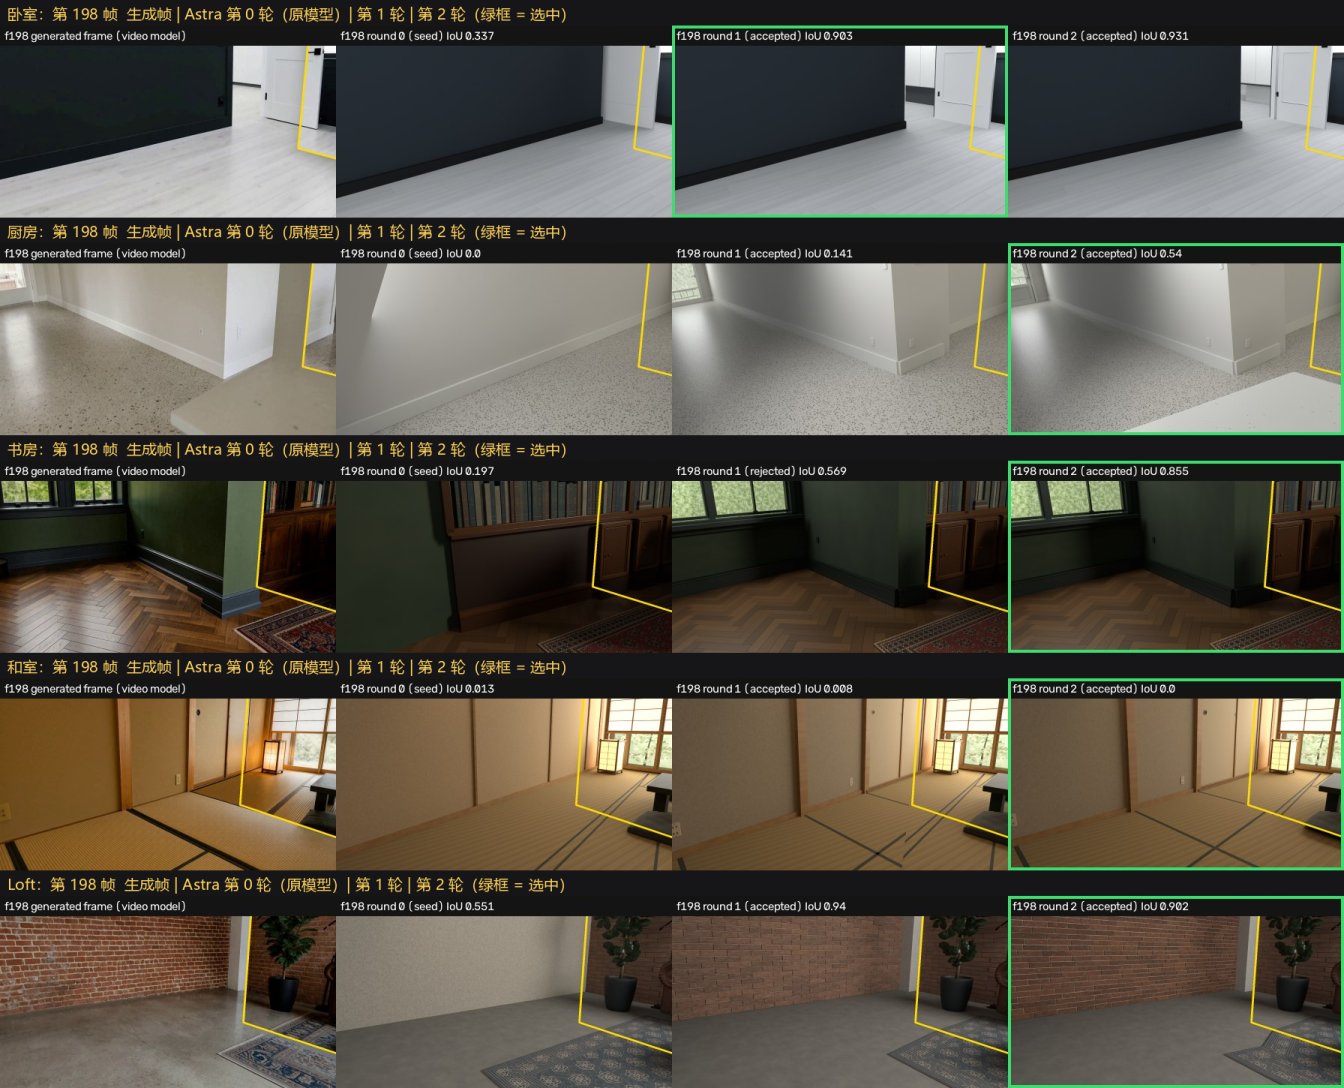
- 闭环把视频的发明建进了模型,参考视角实例 IoU 不降(变化 0 到 +0.014);门控拦下 1 轮,Astra 下一轮收到原因后改正。
- 第二遍:复访更一致,照片区域不变。洞内复访 PSNR 升 0.6–8.0 dB,观测区对照片的 PSNR 前后差 ≤ 0.1 dB。
- 局限:打分依赖 SAM 3 的概念表,素墙、木柱这类结构看不到;Astra 会把第一遍的生成瑕疵当真(厨房的白色方块),需要再加一道视觉语言模型质检;只验证了只旋转的轨迹,每个场景 1 个种子。
十三、和外部 baseline 比:WorldPlay、Voyager
论文需要外部对比对象。选了两个开源、能单图 + 相机轨迹生成、主打「长时一致」的方法,在同一测试集上实跑,用同一套指标打分:
- WorldPlay(腾讯 HY-World 1.5,arXiv 2512.14614,2025-12 开源):隐式记忆世界模型(重构上下文记忆),目前开源的长时几何一致性 SOTA;它的论文表格还给了 CameraCtrl、SEVA、ViewCrafter、Gen3C、VMem、Matrix-Game-2.0、GameCraft 的结果。我们用官方双向模型、自定义相机位姿、253 帧 848×480,每条约 62 分钟。
- Voyager(arXiv 2506.04225):显式点云世界缓存 + RGB-D 联合生成,WorldScore 第一;和我们同属「显式 3D 记忆」,但靠单目深度和训练。我们按它的方式把 237 帧轨迹拆成 6 段,每段把生成的 RGB-D 加进缓存再渲染下一段条件,每条约 28 分钟。
- 测试集:10 个场景、同一条回访旋转轨迹(左转 40° → 回到照片 → 左转 55° 并俯 12° → 回到照片)。两个模型都在 AMD MI300X / MI350X 上跑通(替换 flash-attention 为 PyTorch SDPA,修了 Voyager VAE 的段错误)。
| 10 个场景均值(单 seed) | 旋转误差 ° ↓ | 到达率 56° | 回访 LPIPS ↓ | 照片外回访 PSNR ↑ | 对照片 PSNR ↑ | MEt3R ↓ | 照片外边缘密度 | VBench 美学 ↑ |
|---|---|---|---|---|---|---|---|---|
| WorldPlay | 18.82 | 0.24 | 0.515 | 10.45 | 12.10 | 0.128 | 0.078* | 0.598 |
| Voyager | 0.87 | 0.98 | 0.333 | 13.71 | 15.16 | 0.234 | 0.050 | 0.502 |
| 原版 H3 ref2va | 8.28 | 0.91 | 0.196 | 18.99 | 17.71 | 0.072 | 0.040 | 0.542 |
| 我们:白膜线稿全控制 | 1.06 | 0.99 | 0.055 | 27.48 | 14.52 | 0.018 | 0.041 | 0.530 |
| 我们:+ 洞内清零 + 照片 inpaint | 3.20 | 0.85 | 0.058 | 19.89 | 26.55 | 0.018 | 0.071 | 0.563 |
| 我们:+ Astra 扩模闭环 | 2.90 | 0.91 | 0.057 | 26.85 | 26.54 | 0.017 | 0.077 | 0.561 |
| 我们:洞内整张外壳线稿 + 记忆缓存 | 0.91 | 0.97 | 0.054 | 38.05 | 26.37 | 0.017 | 0.029 | 0.536 |
| 我们:洞内只给外壳边缘、其余清零 | 1.04 | 1.00 | 0.057 | 24.12 | 26.50 | 0.017 | 0.073 | 0.559 |
| 我们(主行):外壳边缘 + 记忆缓存 | 0.68 | 0.98 | 0.054 | 31.91 | 26.41 | 0.017 | 0.071 | 0.552 |
| 主行 3 个 seed 均值 ± seed 间标准差 | 0.92 ± 0.49 | 0.96 | 0.054 | 31.6 ± 0.6 | 26.6 ± 0.2 | 0.017 | 0.075 | — |
回访 LPIPS:回到照片视角的帧对首访帧。照片外回访:第二次左转帧经单应性对齐到第一次左转帧,只算两次都可见、照片看不到的像素。MEt3R:无需位姿的 3D 一致性(ROCm 移植版,与官方实现差 ≤ 0.0014)。边缘密度:第二次左转停留帧里照片看不到的区域的 Canny 边缘占比,越高内容越多。* WorldPlay 没转过去,那块区域里多是照片内容,不可比。
- 回访一致性和照片保真大幅领先。回到照片视角时与首访的 LPIPS 0.054 对 0.33(Voyager)/ 0.52(WorldPlay);MEt3R 0.017 对 0.23 / 0.13;对照片 26 dB 对 15 / 12 dB。
- 相机:主行旋转误差 seed 43 为 0.68°,3 个 seed 均值 0.92° ± 0.49(seed 123 在 colorful 上没转完;去掉这一例为 0.85°),和 Voyager(0.87°)同档;WorldPlay 只转到指令角的 24–34%。把轨迹放慢 3 倍再给 WorldPlay(6 个场景),去程能转到 74%,但长序列漂移、回不到起点(残差 20.6°),回访一致性反而更差,所以不是「只是速度太快」。
- 一个陷阱和它的修法:洞内给整张外壳线稿图时,没有边的位置是全黑控制,模型把它读成空墙(照片外边缘密度 0.03,38 dB 的一致性有一部分来自「画得简单」)。改成只在外壳边缘给控制、其余清零后,内容回到自由生成水平(0.073),再叠记忆缓存,一致性 31.9 dB、内容 0.071、相机 0.68°(3 个 seed:31.6 dB、0.075、0.92°),作为主行。缓存的一致性是按构造得到的(第二次访问复用第一次的内容)。VBench 美学我们仍比 WorldPlay 低约 0.05。
- 说明:我们多用了一份 Astra 从照片建的 3D 场景(每个场景约 $3–4 的 GPT-6 调用);baseline 和消融行是单 seed,主行补了 3 个 seed;10 张参考图里 9 张是生成图;没有真实 GT 视频,只在照片视角有真值。
十四、方法与局限
- 所有实验都不训练任何模型;LingBot、SolarWM-H3 只改证据画面和注入方式,原版 H3 只改输入和提示词。H3 Fun-ControlNet 和 VACE 是别人训练好的控制模型,我们直接用。
- 重合度只看床、床头柜、窗、门、床头板五类物体,SAM 3 漏检时会偏低;转身过程中的过渡帧本来就很难对齐,所以看停留段更有意义。
- 原版 H3 每次 ref2va 在 MI300X 单卡约 45–50 分钟,MI350X 约 27 分钟;Fun-ControlNet 25 步在 MI350X 上约 10 分钟。各组种子数不同:卧室 R3a 和 Fun-ControlNet 主配置各 4 个种子,新场景 2–3 个,LingBot 关键组 3 个,其余多数 1 个。
- 10 个场景里 7 个的参考图是图像模型生成的写实室内图(新场景里只有儿童房是真实照片);新场景的物体对齐以 Astra 白膜为真值,Astra 建错的地方(如儿童房、咖啡馆的尺度)也会算进去。
- 物体编号通道早期没有关掉 8 位抖动,约 16% 的像素编号出错;去抖后重算,第二个场景的数值只变了 0.001–0.004,排序不变。
- 机器人在网格里不存在:用白膜或网格铺满画面时,模型会把机器人当成不该有的东西抹掉;保留源视频投影的组合(LingBot 混合证据)能保住动态主体。