画面很真,声音也像真的——它们放在一起,就一定对吗?
未必。塑料杯落在软地毯上,可能响成玻璃碎裂;狗明明一直在叫,音轨却突然安静;倒水、引擎加速这类连续动作,声音也可能完全没有跟着变化。这已经不是简单的「早几帧、晚几帧」问题。真正要判断的是三件事:该不该响、应该是什么声音、是否跟着画面变化。
但想给生成式音视频做自动评测,第一道坎很反直觉——现有同步指标大多默认,音频和视频的内容本来就是对的。
它们更擅长找「声音提前或滞后了多少」,一旦模型生成的是错音色、漏声或结构性失配,这把尺子就不灵了。只要声音大致在正确时间出现,即使它根本不属于这段画面,分数仍可能很好看。
近期,来自浙江大学、香港理工大学、树根科技、三一集团 Wolf 1069b Lab 的团队提出了 Beyond Time Shifts,把人类对音画同步的相对判断,训练成一个可以独立使用的连续评估器。输入单个音视频对,它直接输出实数分数,不需要正确答案,也不需要另一条候选音轨作参照。
在 SynthSync 上,完整模型取得 61.40% Top-1 Accuracy 和 72.38% Pairwise Accuracy;单张 RTX 4090 评估一个音视频对约需 0.23 秒。该工作已被 ECCV 2026 接收,论文、代码、评估器权重与 SyncBench 评测素材均已公开。
下面进入视频 Demo。先戴上耳机,看下面两段。
两个模型收到同一条文字提示,各自生成了「用喷流清洗彩色垫子」的画面和声音。水流、摩擦和动作节奏一直在变化,声音真的跟着画面走了吗?
先听,再看答案。
答案是:A 来自 Veo 3.1,本文评估器给出 7.30;B 来自 LTX-2,得分 0.56。
这里的分数不是十分制,也不评价画质或模型综合能力。它只回答一件事:声音是否在语义、物理和时间上属于眼前这一幕。 分数越高,音画的因果—语义同步越好。
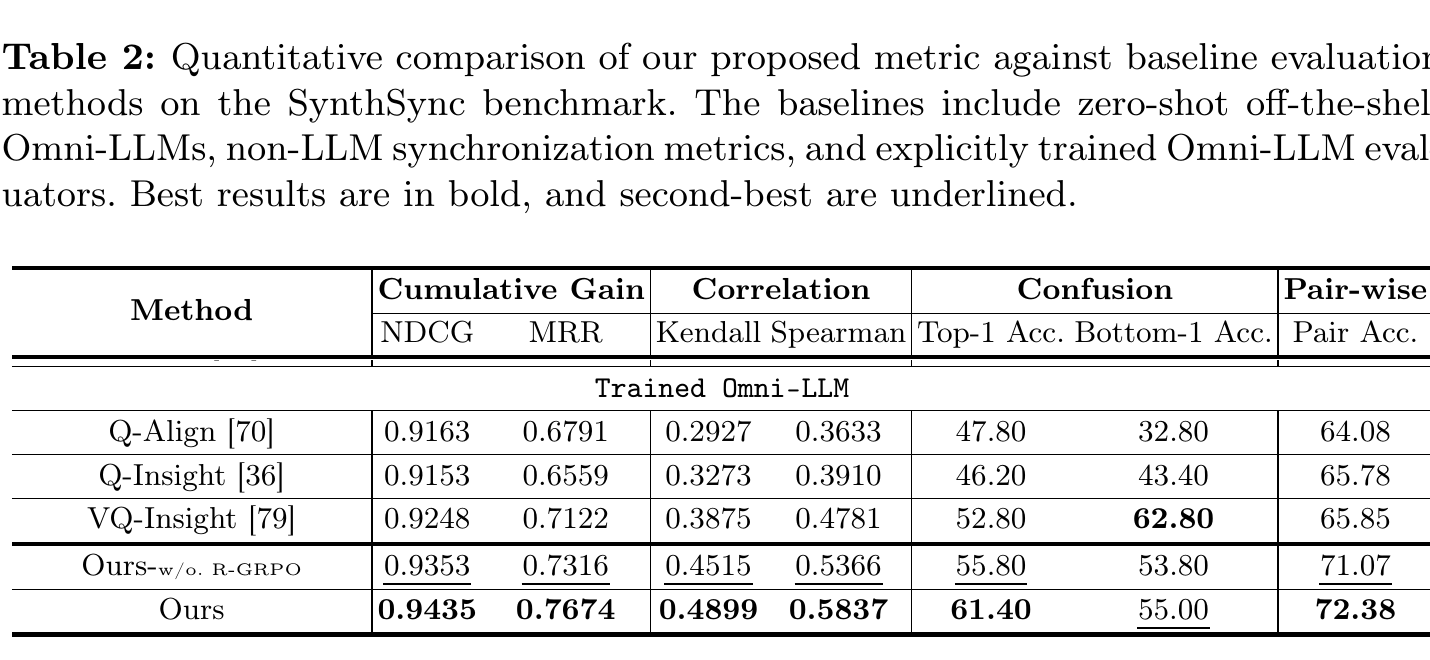
论文 Table 2(移动端裁出表头与相关方法行):完整模型取得 61.40% Top-1 Accuracy 和 72.38% Pairwise Accuracy。
在 SynthSync 测试集上,完整模型取得 61.40% Top-1 Accuracy 和 72.38% Pairwise Accuracy。加入 R-GRPO 后,Top-1 从 55.80% 提升到 61.40%,增加 5.6 个百分点。
单卡推理也不重:在 RTX 4090 上,评估一个音视频对约需 0.23 秒,峰值显存约 10.0 GB。与论文对比的 8.3B LLM 裁判相比,它约快 5 倍,计算量约低 6 倍。
到这里,论文最重要的信息已经齐了。下面再看一组视频,看看这把尺子究竟在「听」什么。
这一组是木工雕刻。除了动作与声响是否同时发生,刀具接触木材的音色、力度和连续性也会影响判断。
注意:每一组只是使用了相同的文字提示,视频和音频都由各模型独立生成,并不是给同一段画面替换不同音轨。分数来自本文评估器,适合帮助观察差异,不能代替完整的人工评审。
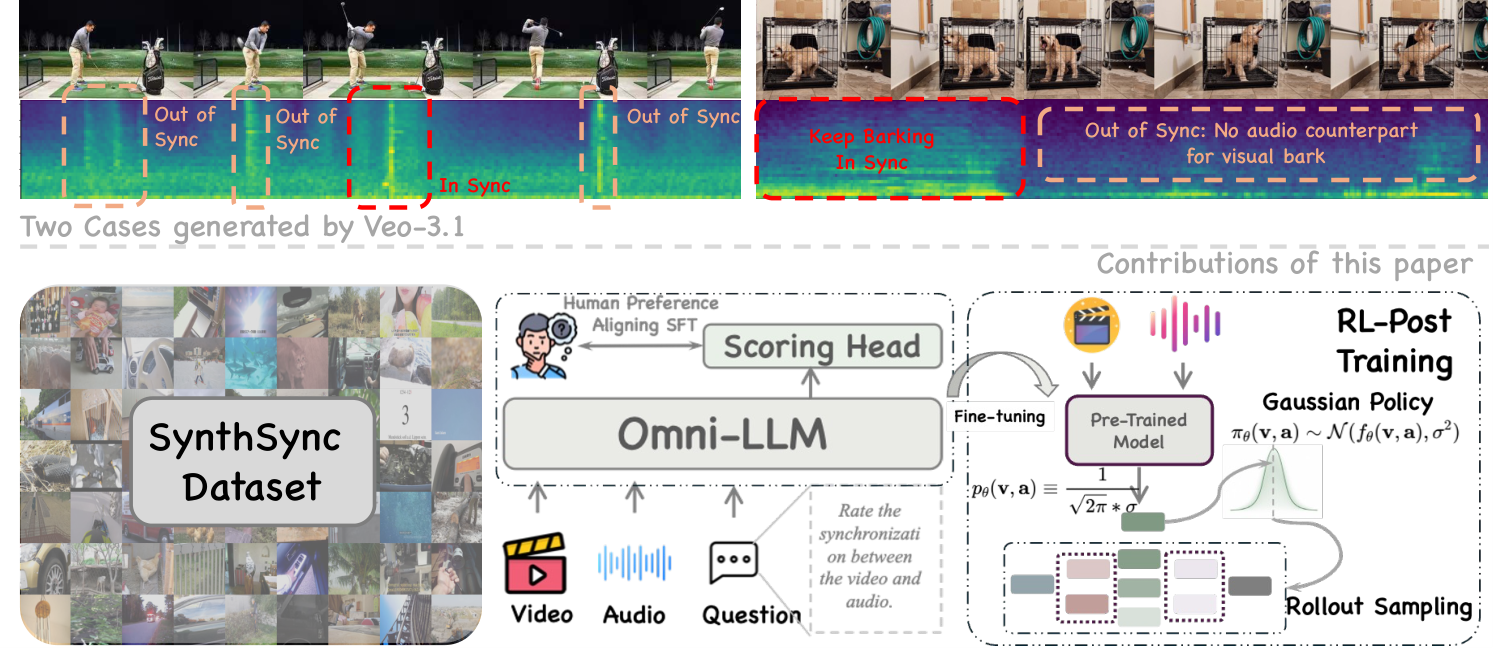
论文 Fig. 1:现代生成模型中的同步失败,以及 SynthSync、连续评分器与 R-GRPO 的整体思路。
传统同步指标通常默认音频和视频的内容本来就是对的,剩下的问题只是 onset 是否对齐、音轨前后偏了多少。
生成内容打破了这个前提。塑料杯落在软地毯上,模型可能配出玻璃碎裂声;画面里的狗一直在叫,音轨却中途沉默;倒水、引擎加速这类连续事件,也没有一个 onset 就能概括。
所以,这项工作的评估目标往前走了一步:不只检查声音「何时出现」,还要判断它「该不该出现、听起来像不像、变化是否跟着画面走」。
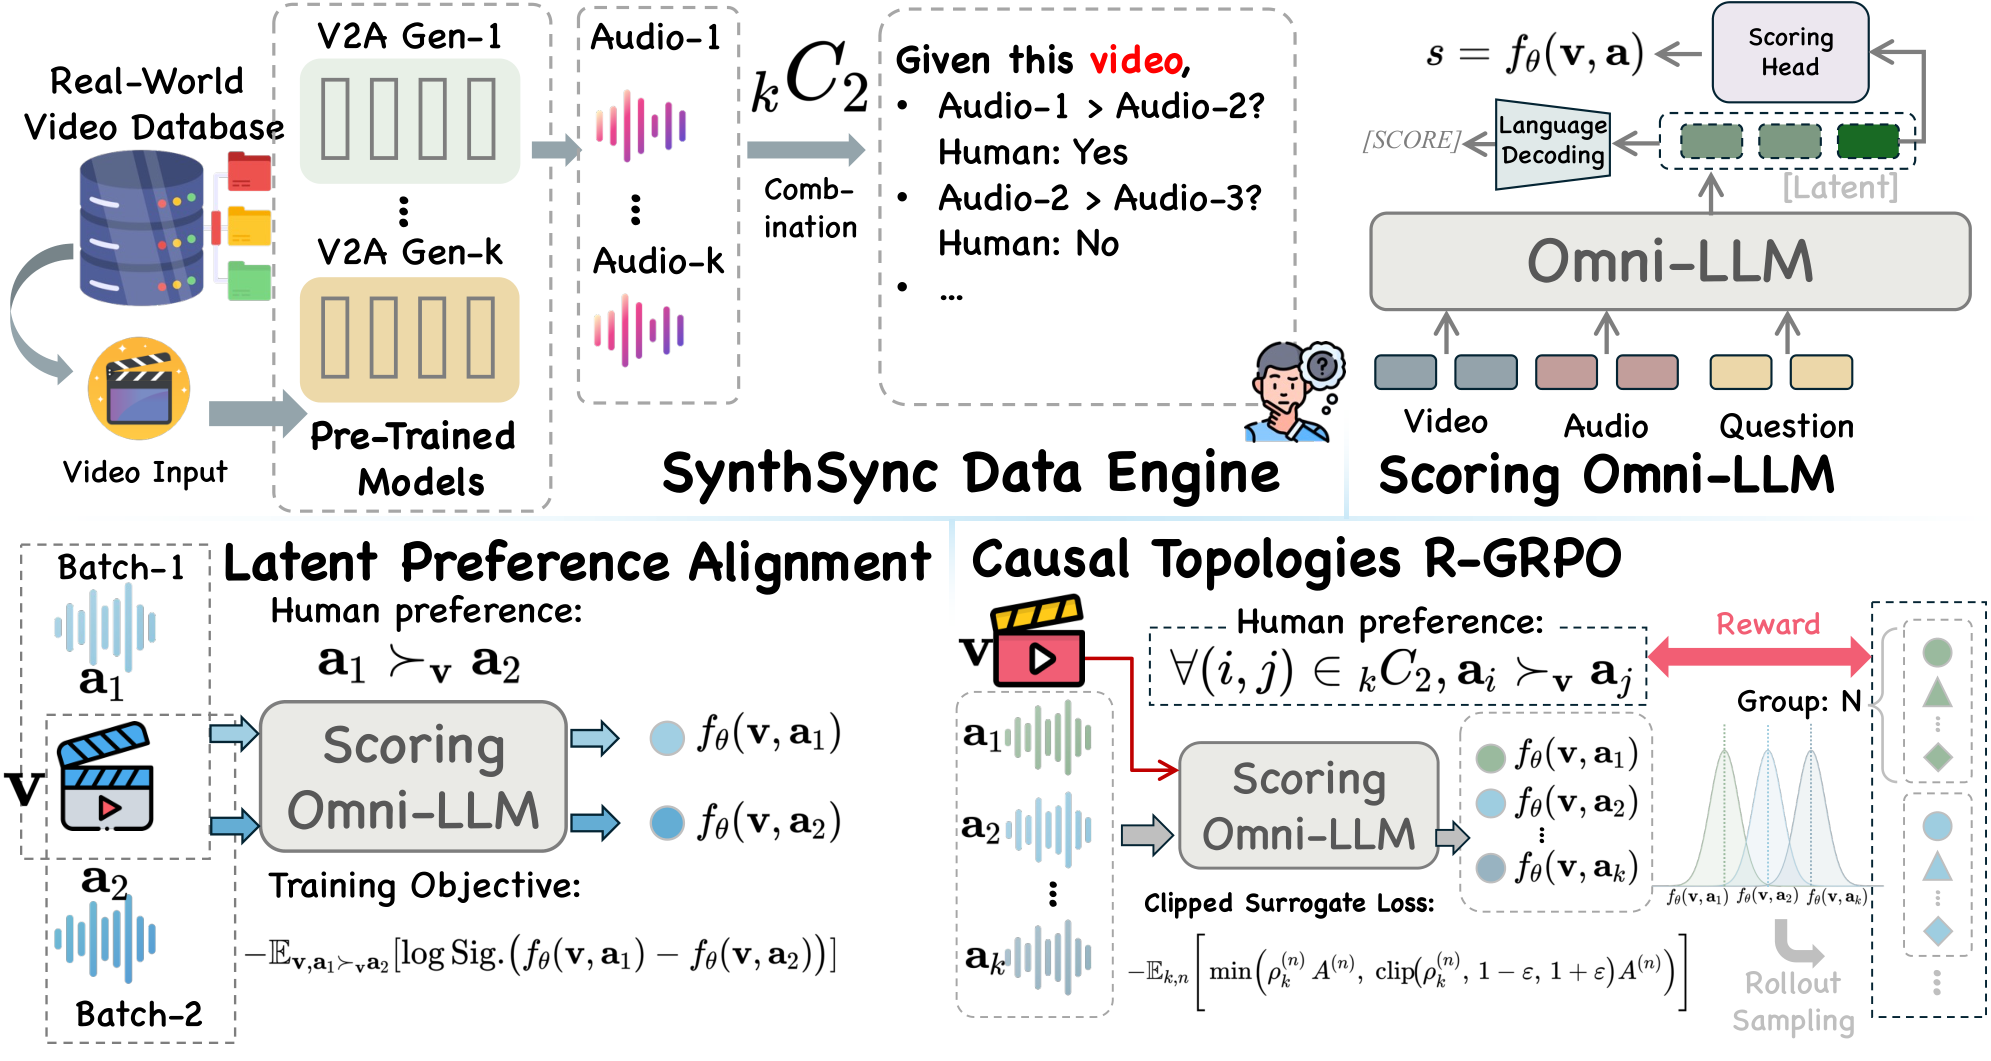
论文 Fig. 2:从真实 V2A 生成错误和人类两两偏好,到连续 Omni-LLM 与 R-GRPO 后训练。
第一步,收集模型真实会犯的错。 团队构建了 SynthSync:从 VGGSound 和 FoleyBench 选取 2,267 个 5 秒视频锚点,让 10 个 V2A 模型分别生成候选音轨。20 名专家分成 3 个独立小组,对每个锚点下的候选做全量两两比较,最终得到约 30.6 万条人类偏好。训练集与测试集按视频划分为 1,767 / 500 个锚点。
第二步,把「A 比 B 好」变成单样本分数。 模型以
Qwen2.5-Omni-3B 为底座,在多模态序列中加入
[SCORE],从对应隐状态直接投影出连续实数,不再让大模型生成
“Good”“Poor”
或数字文本。训练时学习人的两两偏好,推理时只看一个音视频对。
第三步,让整组排序也站得住。 两两判断都对,不代表多个候选放在一起时顺序仍然稳定。R-GRPO 因而直接优化整组候选的排序质量,让评估器从「会分局部胜负」走到「能排全局名次」。
团队进一步构建了 SyncBench:185 条提示词、5 类物理音视频场景,用于评估 6 个联合音视频生成模型。
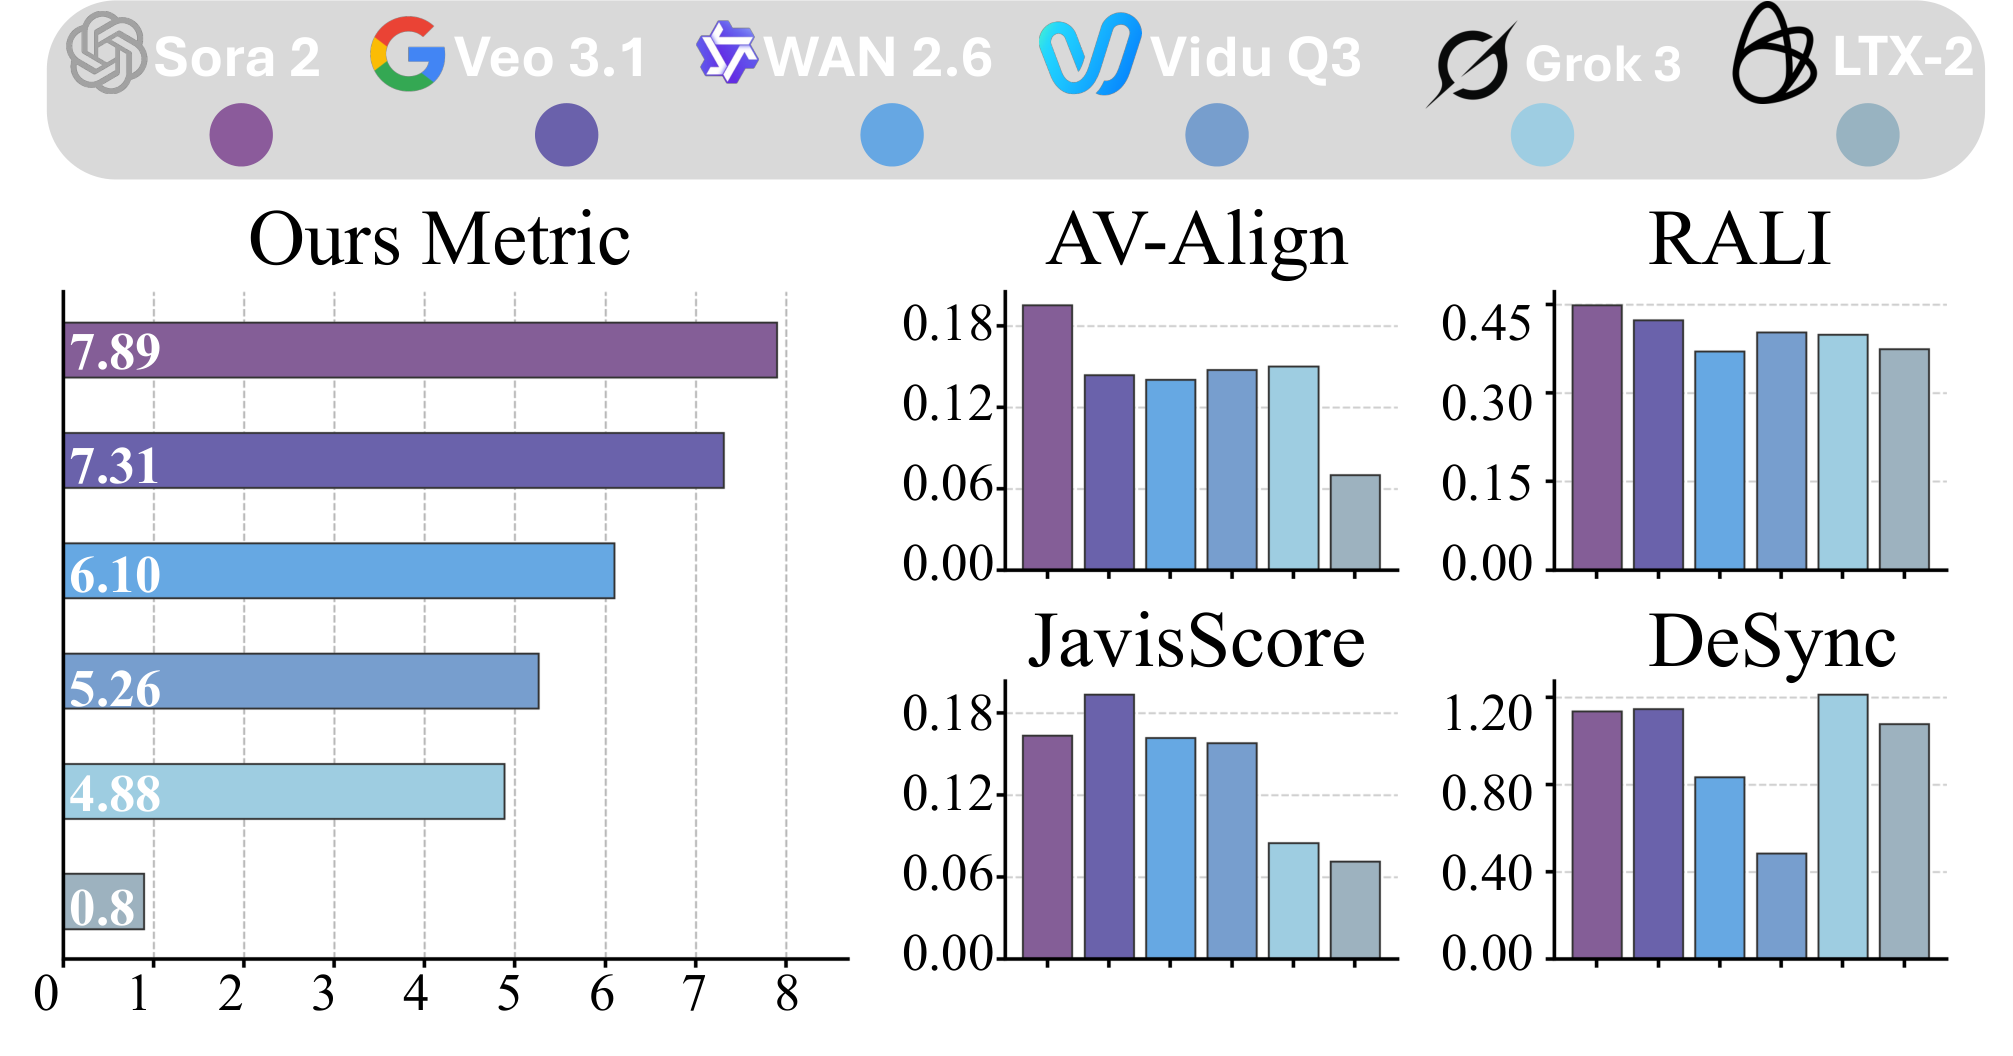
论文 Fig. 5:本文指标与传统基线对六个联合音视频生成模型给出的排序。
按本文指标的平均分,Sora 2 为 7.89,Veo 3.1 为 7.31,随后是 WAN 2.6(6.10)、Vidu Q3(5.26)、Grok 3(4.88)和 LTX-2(0.80)。同一批模型在传统指标下的排序明显波动,说明它们对结构性错误的判断并不稳定。
这些是无界连续分数,允许出现负数或超过 10;它们只代表 SyncBench 和本文指标设定下的音画同步表现,不是六个模型综合能力的排名。
评估器不只用来做榜单。团队让 LTX-2 针对每条提示词生成 12 个候选,再用不同指标各自选出一条。
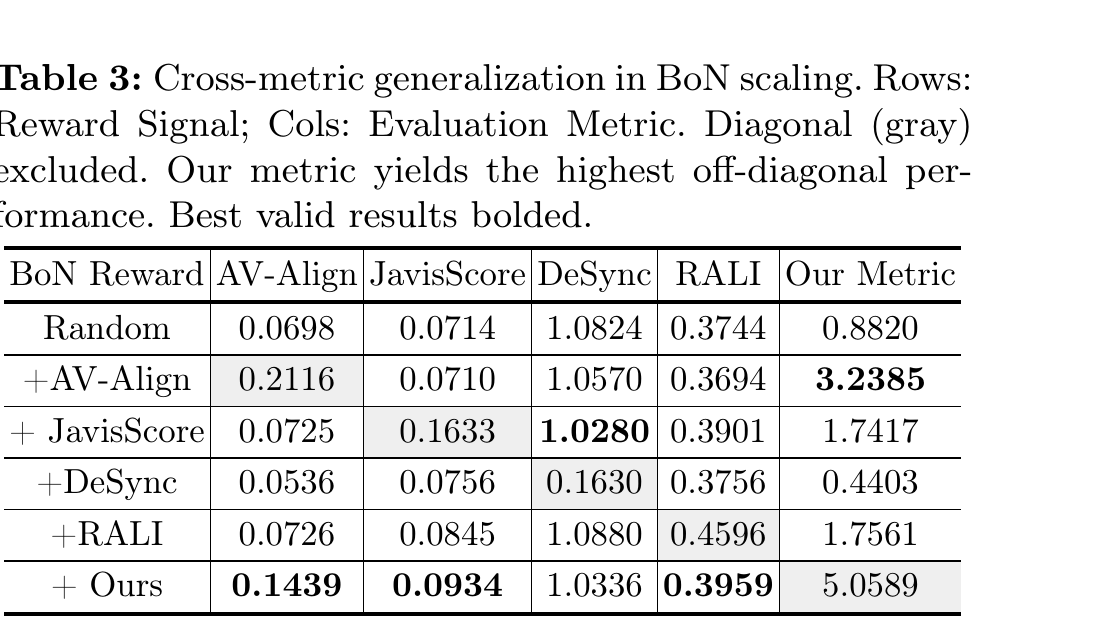
论文 Table 3:灰色对角项不参与判断,粗体为各独立评估指标下的最佳有效结果。
排除「自己选、自己评」的对角项后,由本文评估器选中的结果,在 4 个独立指标中的 3 个拿到最佳成绩。这个分数已经可以参与 Best-of-N:生成一批,再自动挑出音画更协调的版本。
论文主要实验把输入统一为 5 秒、140×140、12 FPS,SynthSync 中的生成错误主要来自 10 个 V2A 模型。遇到更长视频、更细微的高速事件或明显不同的模型分布,仍需要更多人工对照验证。
目前,代码、评估器权重以及 SyncBench 的评测视频与分数均已公开,相关链接见文首。
下一次再遇到「画面没问题,声音却哪里不对」,现在终于有了一把能直接打分的尺子。